CordisBench teste une faiblesse très concrète des agents IA : savoir ce qui arrive quand le logiciel qui organise leur propre exécution est modifié. Ce preprint publié le 1er septembre 2026 ne juge pas la fluidité d’une réponse ; il vérifie, dans un environnement contrôlé, si le modèle peut suivre des dépendances, des arrêts de composants et des reconfigurations qui changent l’état final d’un système.
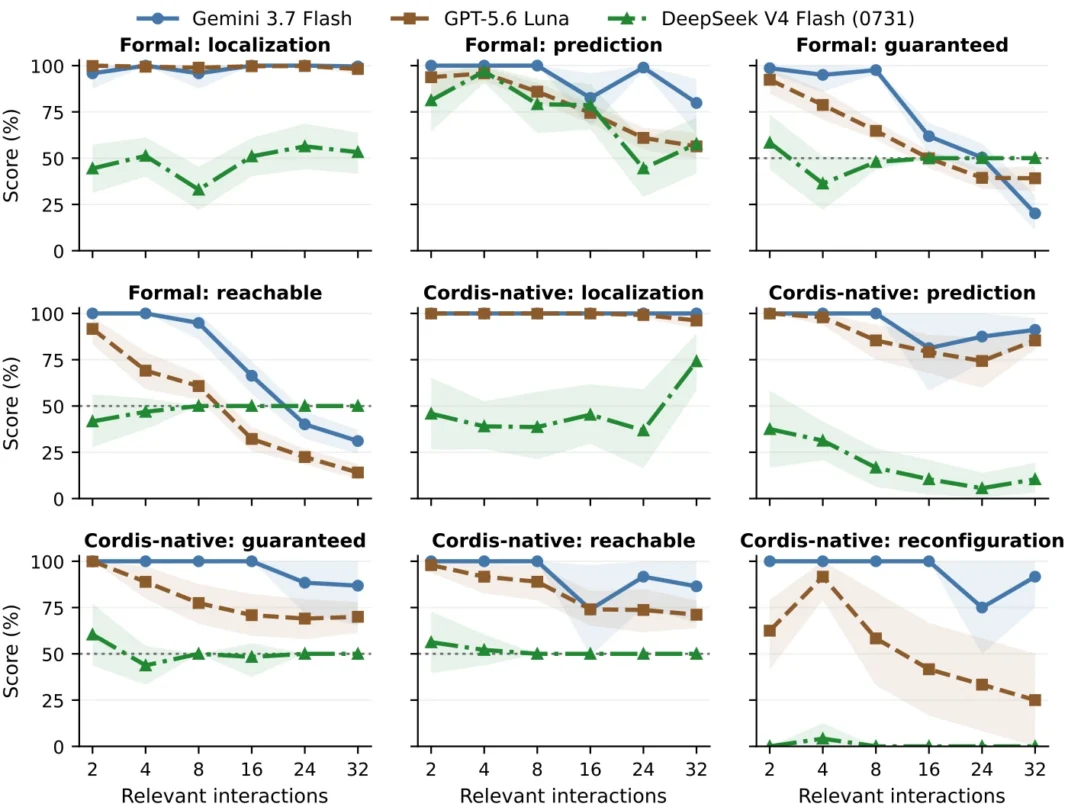
Le résultat important n’est donc pas un nouveau palmarès général. Les auteurs rapportent que les modèles étudiés gèrent plutôt bien les petits systèmes, mais deviennent moins fiables à mesure que le nombre d’interactions pertinentes augmente. Le travail reste un preprint, sans évaluation par les pairs : il faut le lire comme une proposition de test et un signal technique, pas comme une mesure définitive de tous les agents.
Pourquoi le runtime devient une question de raisonnement
Un agent n’agit pas dans le vide. Il s’appuie sur un harness : un ensemble de composants qui fournissent des outils, des états, des dépendances et des mécanismes de nettoyage. Dans un système dynamique, une modification locale — activer un plugin, retirer un composant ou changer une dépendance — peut avoir des effets qui ne se voient qu’au moment où d’autres composants s’arrêtent.
CordisBench cible précisément cette difficulté. Ses 1 200 questions demandent notamment d’identifier les composants affectés, de prédire l’état obtenu après un ordre de démontage donné, de distinguer ce qui reste vrai dans tous les ordres possibles et de choisir une reconfiguration qui fonctionne réellement. L’enjeu est moins de produire du code que de conserver une représentation cohérente du système pendant qu’il se transforme.
Un test qui vérifie l’exécution, pas seulement l’explication
La méthode est l’intérêt principal du projet. Le dépôt associé publie un générateur, des scoreurs déterministes et un runner Cordis. Pour les questions de reconfiguration, une réponse est exécutée contre une version épinglée du runtime : elle doit réussir dans le programme, et non simplement sembler plausible à un évaluateur.
Cette différence compte. Une explication peut décrire correctement une dépendance tout en choisissant une séquence qui échoue dans le logiciel. Le projet conserve aussi des diagnostics stricts, comme la correspondance exacte de la réponse ou son analyse syntaxique. Les auteurs indiquent en outre qu’une sémantique de référence finie indépendante concorde avec l’exécution Cordis pour les 528 questions exécutables retenues dans le scoring. Cela renforce la vérifiabilité interne du test ; cela ne prouve pas, à lui seul, que le benchmark reproduit tous les environnements de production.
Ce que les résultats suggèrent — avec prudence
L’étude fait varier le nombre d’interactions pertinentes, de 2 à 32, et observe trois modèles dans le réglage décrit comme un faible effort de raisonnement. Selon les auteurs, les tâches simples restent souvent accessibles, tandis que la prédiction de l’état final et le raisonnement sur les ordres de nettoyage se dégradent lorsque le système devient plus entremêlé.
C’est un avertissement utile pour les équipes qui veulent laisser un agent modifier ses propres connecteurs ou son orchestration : une bonne performance sur une instruction isolée ne garantit pas qu’il anticipe les effets différés d’un changement. Mais la portée doit rester claire : les résultats concernent les modèles, les invites et le runtime Cordis étudiés. Ils ne permettent pas de classer tous les agents, ni de prédire directement le taux d’incidents dans une infrastructure réelle.
Un angle différent de SWE-bench ou AgentBench
Les benchmarks d’agents ne répondent pas tous à la même question. SWE-bench part d’issues et de correctifs GitHub réels : il teste la capacité à modifier un dépôt pour résoudre un problème logiciel. AgentBench répartit l’évaluation sur huit environnements afin d’observer décision et interaction. CordisBench, lui, isole le raisonnement sur le cycle de vie de l’infrastructure qui rend l’agent opérant.
Il serait donc trompeur de comparer directement leurs scores. Leur complémentarité est plus instructive : résoudre une issue, agir dans un environnement et maintenir la cohérence d’un harness mutable sont trois compétences différentes. Un agent destiné à intervenir durablement dans une chaîne d’outils devrait idéalement être testé sur les trois plans.
La prochaine étape : confronter ce test à des systèmes plus variés
Le jeu de données et le code sont publics, ce qui permet de reproduire le protocole et de vérifier les tâches. La limite centrale est aussi celle de la plupart des nouveaux benchmarks : un environnement contrôlé rend la mesure plus nette, mais il simplifie nécessairement la diversité des runtimes, des permissions et des échecs observés en production.
Pour les lecteurs et les équipes techniques, le bon usage de CordisBench est donc précis : l’employer pour examiner une aptitude souvent masquée par les démonstrations d’agents, puis compléter ce diagnostic par des tests sur leur propre orchestration. Le preprint met surtout une question utile sur la table : un agent qui sait appeler des outils sait-il aussi prévoir ce que ses modifications font au système qui lui permet de les appeler ?