 Tech et IA
MeMo : la mémoire séparée qui veut rendre les LLM plus faciles à mettre à jour
MeMo propose d’ajouter un modèle de mémoire spécialisé à côté d’un LLM gelé. L’idée pourrait aider les agents et applications d’entreprise, mais reste au stade expérimental.
Sur quoi repose cet articleExplication
Type de travail
Article d’explication
À garder en tête
Une synthèse des connaissances : suivez les sources pour aller plus loin.
Au moins une source est une prépublication, pas encore relue par des pairs.
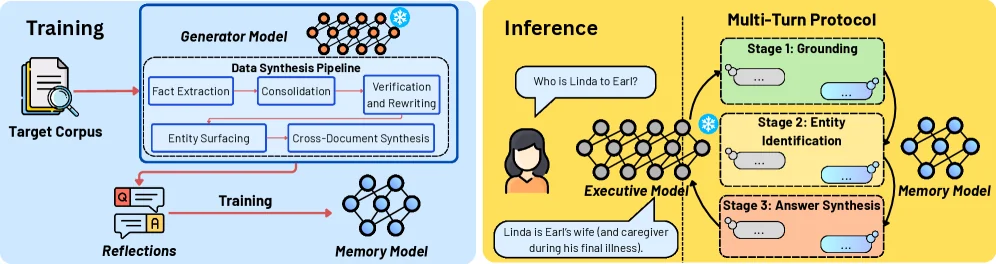
Et si la mémoire d’un grand modèle de langage ne devait plus être enfouie dans le modèle lui-même ? C’est l’idée défendue par MeMo, pour Memory as a Model, une prépublication arXiv soumise le 14 mai 2026 et révisée le 20 mai. Le travail, signé par des chercheurs liés notamment à la National University of Singapore, A*STAR, MIT CSAIL et SMART, propose d’entraîner un modèle de mémoire séparé, interrogeable par un LLM principal laissé gelé.
Le sujet est important pour les applications d’IA qui doivent intégrer des connaissances nouvelles sans relancer un entraînement massif. Les auteurs positionnent MeMo entre trois familles connues : la récupération de documents de type RAG, le fine-tuning ou préentraînement continu, et les méthodes de mémoire latente. Leur pari : séparer la mémorisation et le raisonnement afin de conserver un modèle principal inchangé tout en lui donnant accès à un corpus appris par un autre modèle.
Ce que MeMo change par rapport au RAG classique
Dans un système RAG, le modèle reçoit au moment de la requête des documents récupérés dans une base externe. Le papier MeMo rappelle deux limites de cette approche : les fenêtres de contexte restent bornées, et les questions qui exigent de relier des informations dispersées dans plusieurs documents peuvent être difficiles à traiter quand la récupération est bruitée ou incomplète.
MeMo prend une autre voie. Un Memory model est entraîné sur un corpus cible pour internaliser des connaissances. Un Executive model, c’est-à-dire le LLM principal, reste gelé. Au moment de répondre, l’Executive model décompose la question, interroge le Memory model au fil d’un protocole multi-tour, puis raisonne sur les réponses intermédiaires. Le papier insiste sur un point pratique : l’Executive model peut être utilisé comme une boîte noire, sans accès à ses poids ni à ses logits.
Une architecture pensée pour les modèles ouverts et propriétaires
Dans les expériences décrites, les chercheurs utilisent Qwen2.5-32B-Instruct comme modèle générateur pour transformer les textes en données d’entraînement, puis Qwen2.5-14B-Instruct comme modèle de mémoire. L’Executive model évalué est soit Qwen2.5-32B-Instruct, soit Gemini-3-Flash. Cette configuration sert à tester l’idée centrale : une mémoire apprise séparément peut-elle être interrogée par des modèles de raisonnement différents, y compris un modèle propriétaire ?
C’est là que MeMo vise une difficulté appelée par les auteurs representation coupling. Certaines méthodes de mémoire compacte créent des représentations liées au modèle qui les a produites. MeMo cherche au contraire à rendre la mémoire consultable par un autre modèle via une interface texte, ce qui rend l’approche plus compatible avec des LLM fermés ou remplacés au fil du temps.
Des résultats encourageants, mais encore très expérimentaux
Les résultats rapportés portent sur trois benchmarks : BrowseComp-Plus, NarrativeQA et MuSiQue. Sur NarrativeQA, MeMo atteint 26,85 % avec Qwen2.5-32B-Instruct et 53,58 % avec Gemini-3-Flash. Sur MuSiQue, les scores indiqués sont 48,30 % et 58,70 % selon l’Executive model. Sur BrowseComp-Plus, MeMo est en tête avec Gemini-3-Flash à 66,67 %, mais reste derrière HippoRAG2 dans le réglage avec Qwen2.5-32B-Instruct, où MeMo obtient 54,22 % contre 56,11 % pour HippoRAG2.
Ces chiffres ne doivent pas être lus comme une victoire générale contre le RAG. Ils montrent plutôt un compromis : MeMo semble plus adapté aux questions qui demandent une synthèse à travers de longues relations documentaires, tandis que les méthodes de récupération peuvent rester fortes lorsque la bonne réponse dépend surtout d’un accès direct à des documents précis. Le papier lui-même présente BrowseComp-Plus comme un cas où l’accès aux preuves brutes peut avantager les méthodes qui transmettent les documents au modèle de raisonnement.
Pourquoi les agents IA sont concernés
Pour les agents IA, le problème n’est pas seulement de produire une réponse fluide. Un agent de code, de support, de recherche ou d’analyse doit souvent maintenir une connaissance de procédures, d’outils, de documents internes ou de dossiers évolutifs. Le fine-tuning complet peut être coûteux et risquer de dégrader des connaissances existantes. Le RAG peut fonctionner, mais dépend de la qualité de la récupération et de la place disponible dans le contexte.
MeMo propose donc une piste intermédiaire : créer un composant de mémoire spécialisé, séparé du modèle qui planifie et raisonne. Si cette piste se confirme, elle pourrait intéresser les architectures d’agents qui doivent changer de modèle principal sans reconstruire toute leur base de connaissances. Mais cette projection reste prudente : la démonstration actuelle est celle d’un papier de recherche, pas d’un produit déployé à grande échelle.
Les limites à garder en tête
La première limite est le statut du travail : il s’agit d’une prépublication arXiv, pas d’un article relu par les pairs dans une revue. La deuxième concerne le coût et la complexité de la préparation. MeMo ne supprime pas l’apprentissage : il déplace l’effort vers la création d’un jeu de questions-réponses de réflexion et l’entraînement d’un modèle de mémoire.
Il faut aussi éviter une lecture magique du mot “mémoire”. Le Memory model n’est pas une base de données transparente ; il reste un modèle de langage entraîné, donc susceptible d’erreurs. Le fait de séparer mémoire et raisonnement ouvre une voie intéressante pour les systèmes modulaires, mais ne règle pas à lui seul les questions de vérification, de traçabilité et de fraîcheur des sources.
Ce qu’il faut retenir
- MeMo entraîne un modèle de mémoire séparé au lieu de modifier le LLM principal.
- L’Executive model reste gelé et interroge la mémoire via un protocole multi-tour.
- L’approche est testée avec Qwen2.5-32B-Instruct et Gemini-3-Flash.
- Les résultats sont prometteurs sur certains benchmarks de raisonnement documentaire, mais pas uniformément supérieurs aux meilleures méthodes de récupération.
- Pour les agents IA, l’intérêt principal est la modularité : changer de modèle de raisonnement sans jeter toute la mémoire spécialisée.
La discussion