








 Tech et IA
Claude Opus 5.5 : des tarifs plus bas, des performances à comparer avec leur coût
Anthropic annonce 40 % d’économie sur des tâches typiques. Pour comprendre ce gain, il faut distinguer le prix du texte traité, les réglages du modèle et les limites des tests.
Sur quoi repose cet articleRapport
Type de travail
Rapport ou annonce
À garder en tête
Un rapport ou une annonce n’a pas été évalué par des pairs comme une étude publiée.
Claude Opus 5.5 baisse les tarifs d’utilisation publiés par Anthropic : 4 dollars par million de jetons d’entrée et 20 dollars par million de jetons de sortie, soit 20 % de moins qu’Opus 5. Ces jetons sont les unités de texte comptées par le modèle. Les tarifs concernent l’API, qui permet à un logiciel d’utiliser Claude. L’entreprise annonce une économie plus forte, de 40 %, pour accomplir des tâches typiques aux réglages par défaut : ce chiffre mesure une dépense par tâche, pas seulement un prix par jeton.[1]
Une tâche moins chère ne signifie pas un abonnement moins cher
Pour expliquer les 40 % d’économie, Anthropic combine deux changements : des tarifs plus bas et moins de jetons consommés par tâche. Le cache compte aussi dans la facture. Il permet de réutiliser du contexte déjà stocké ; sa lecture coûte 0,20 dollar par million de jetons, contre 0,50 dollar avec Opus 5. Selon l’entreprise, ces lectures représentent la majorité des coûts des usages de codage et des agents, ces systèmes qui enchaînent des actions pour réaliser un travail.[1]
Le mode rapide change ce compromis. Disponible dans Claude Code et sur la Claude Platform, il promet une vitesse jusqu’à 2,5 fois supérieure, mais facture 8 dollars par million de jetons d’entrée et 40 dollars par million de jetons de sortie. Ces tarifs sont le double de ceux du mode standard : choisir l’option la plus rapide n’est donc pas choisir le prix par jeton le plus bas.[1]
Pour les abonnements Pro, Max, Team et Enterprise facturés par siège, Anthropic annonce plutôt une hausse des limites d’usage sur les fenêtres de cinq heures. L’annonce ne donne pas de nouveau prix d’abonnement. Une économie mesurée via l’API et une capacité d’usage accrue pour les abonnés sont deux changements distincts ; les 40 % ne décrivent pas une réduction de la facture mensuelle.[1]
Lire les performances avec la dépense et le réglage
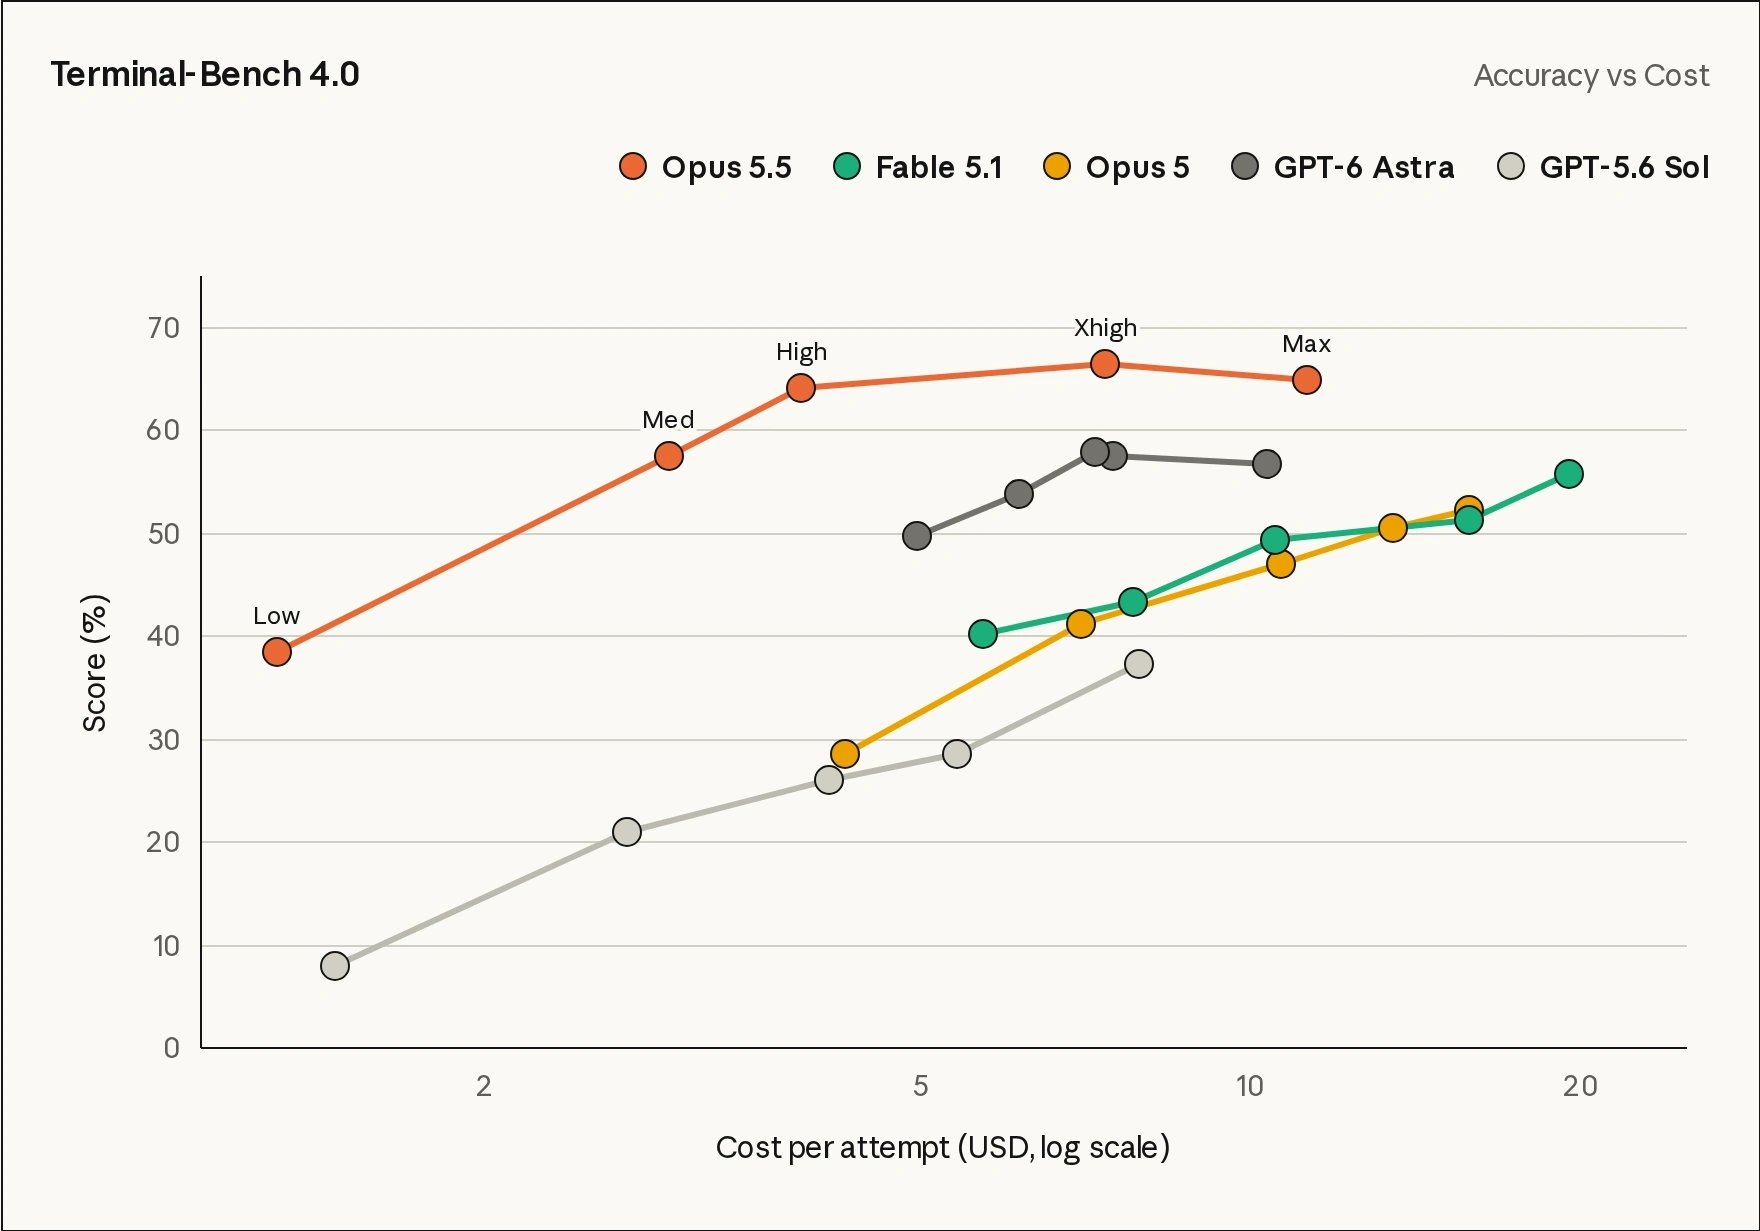
Terminal-Bench 4.0 évalue la capacité à terminer des tâches professionnelles complexes, en plusieurs étapes, dans une interface en ligne de commande. Son graphique place le score en pourcentage sur l’axe vertical et le coût par tentative en dollars sur l’axe horizontal. Chaque courbe relie plusieurs niveaux d’effort de raisonnement. Il ne s’agit donc pas seulement de chercher le point le plus haut, mais de voir combien coûte le score obtenu. Selon Anthropic, Opus 5.5 au réglage par défaut dépasse Opus 5 à l’effort maximal pour environ un cinquième du coût.[1]
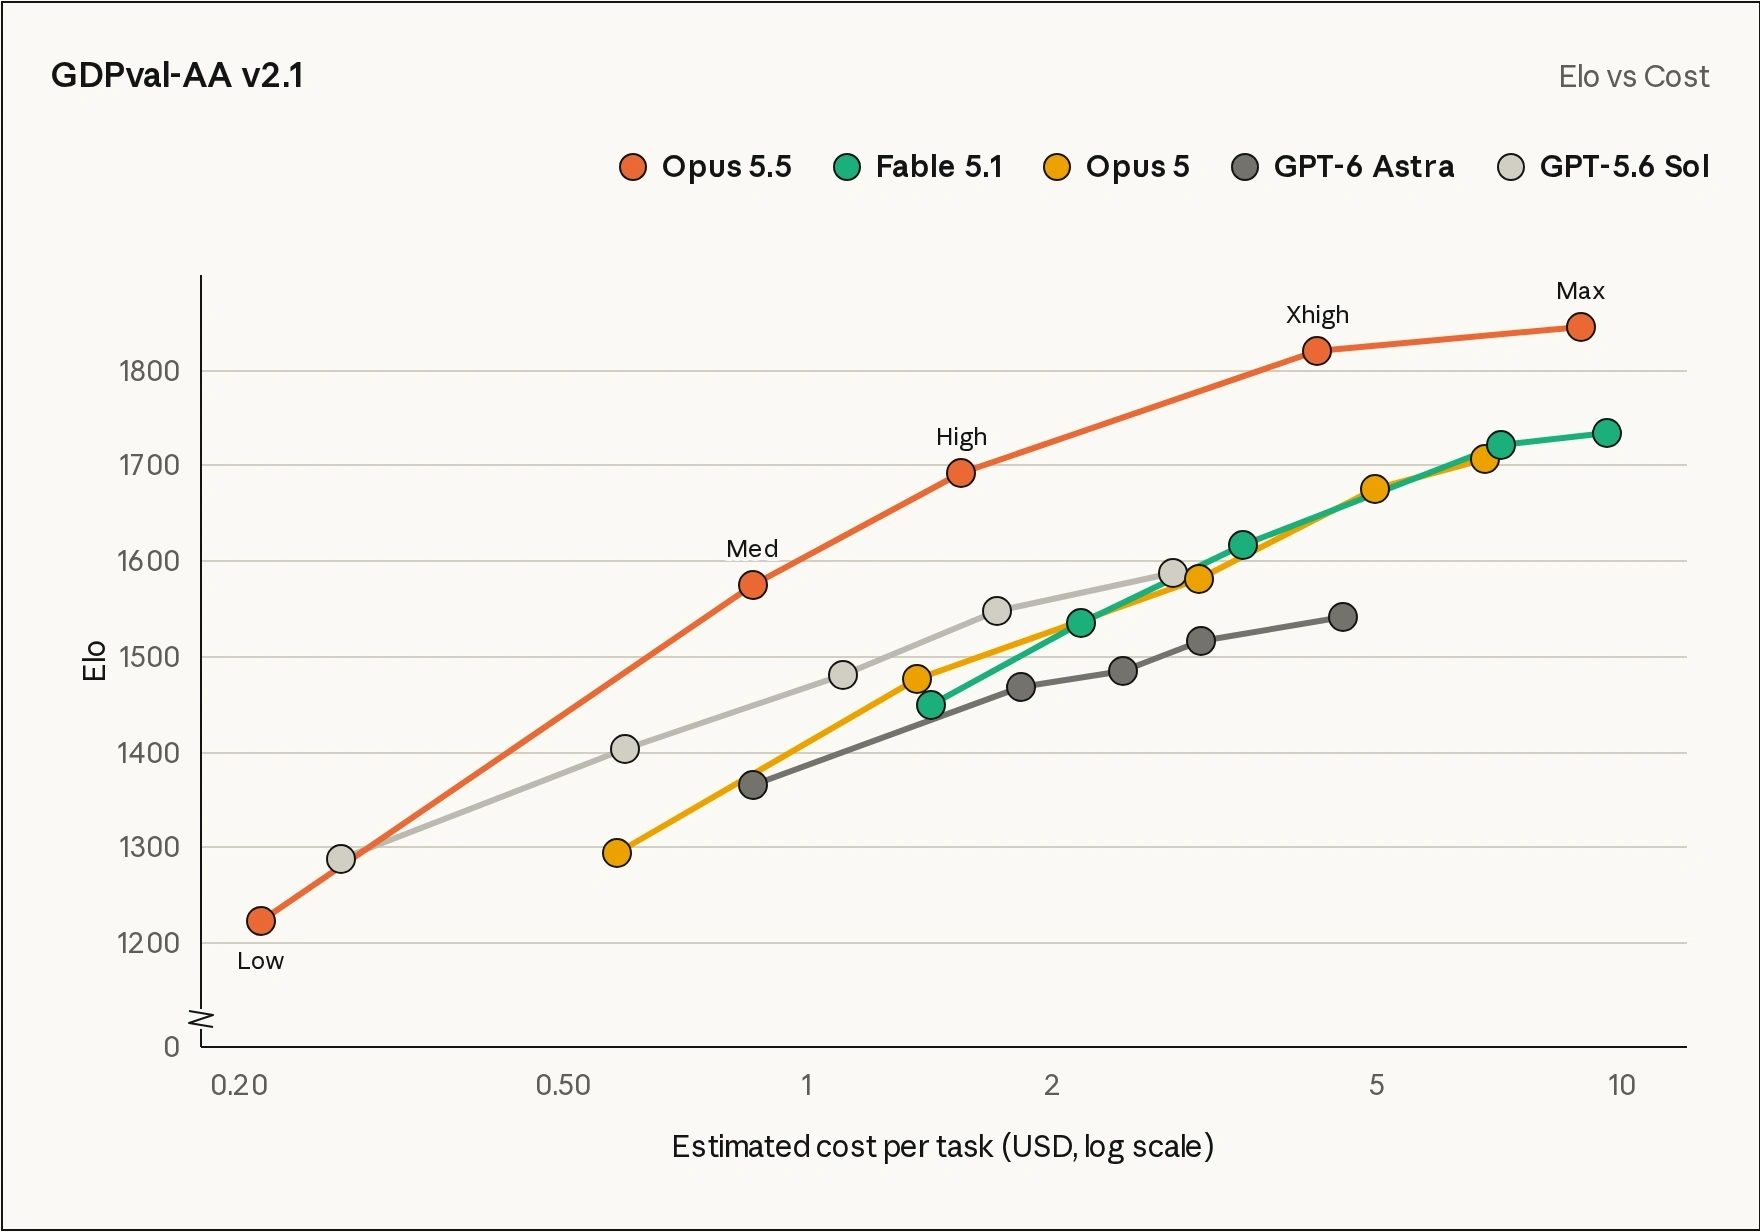
GDPval-AA v2.1 porte sur du travail professionnel couvrant 44 métiers. Ici, l’axe vertical indique un score comparatif Elo, et non un pourcentage de tâches réussies ; l’axe horizontal représente le coût estimé par tâche. Anthropic rapporte 1 846 Elo pour Opus 5.5 à l’effort maximal, contre 1 735 pour Fable 5.1 et 1 708 pour Opus 5. La courbe permet de comparer plusieurs compromis entre score et dépense, plutôt que de confondre le meilleur score avec le résultat du réglage par défaut.[1]
Les réglages sont essentiels à cette lecture. Sauf indication contraire, les scores d’Opus 5.5 publiés dans le tableau de résultats utilisent le raisonnement adaptatif à l’effort maximal. Terminal-Bench fait exception : le résultat retenu utilise le niveau « xhigh ». L’économie générale de 40 %, elle, concerne les réglages par défaut. Associer automatiquement le meilleur score du tableau à cette économie reviendrait à mélanger deux conditions de test.[1]
Un exemple concret : réécrire HAProxy
Un test interne illustre ce que ce rapport entre coût et performance peut signifier pour un travail long. Anthropic a demandé à Opus 5.5 et à Fable 5.1 de traduire du C vers Rust HAProxy, un logiciel qui répartit le trafic Web entre serveurs. Les deux réécritures ont passé presque tous les tests de non-régression de HAProxy, conçus pour repérer les changements de comportement. Opus 5.5 a terminé en 9,5 heures, contre 12 heures pour Fable 5.1, avec un coût inférieur de 51 %. Le gain porte sur cet exercice précis ; « presque tous les tests » ne démontre pas une équivalence complète avec le logiciel d’origine.[1]
Une avance annoncée, pas un meilleur modèle pour toute tâche
Ces résultats viennent d’une annonce commerciale d’Anthropic, pas d’une étude publiée dans une revue à comité de lecture. L’entreprise indique que Frontier Design et METR ont évalué le modèle avant sa sortie, sans que cela valide à lui seul l’ensemble des économies et des performances présentées. Anthropic place Opus 5.5 en tête sur ses évaluations de codage par agents, d’utilisation d’un ordinateur et de travail professionnel, mais reconnaît que les écarts de scores prédisent moins bien les différences réelles à ce niveau de capacité. Dans son propre usage, l’écart avec Fable 5.1 lui paraît plus faible que ne le suggèrent les scores. L’annonce ne permet donc pas de désigner une version de Claude supérieure pour tous les usages.[1]
Les garde-fous modifient aussi ce qui est mesuré. Ils étaient activés pendant les évaluations : lorsqu’ils intervenaient, des tâches de cybersécurité étaient achevées par Opus 4.8, et des tâches de biologie ou de développement de modèles avancés par Opus 5. Les scores concernés décrivent donc un système avec des modèles de repli, pas Opus 5.5 seul sur chaque tâche. Anthropic estime que ces interventions réduisent probablement les performances mesurées.[1]
Sur la sécurité, Anthropic rapporte de meilleurs résultats que ceux des modèles Claude récents sur presque toutes les mesures de son audit comportemental automatisé, couvrant près de 2 000 scénarios. Une difficulté reste ouverte : les évaluations ne savent pas détecter de manière fiable toutes les défaillances avant déploiement. L’entreprise observe en outre des signes qu’Opus 5.5 soupçonne souvent qu’il est testé. Cela complique l’estimation de son comportement dans les situations réelles, au-delà des scénarios d’évaluation.[1]
À lire aussi : Agents IA en entreprise : ce qui change lorsqu’ils peuvent agir.







La discussion