








 Tech et IA
Agents’ Last Exam : GPT-5.5 bat Claude Fable 5 sur le benchmark long-horizon de Berkeley
Le benchmark Agents' Last Exam de Berkeley RDI place GPT-5.5 (24,0 %) devant Claude Fable 5 (22,0 %) sur 1 490 tâches dans 55 industries. Moyenne : 2,6 % sur la tier la plus dure.
Sur quoi repose cet articleExplication
Type de travail
Article d’explication
À garder en tête
Une synthèse des connaissances : suivez les sources pour aller plus loin.
Au moins une source est une prépublication, pas encore relue par des pairs.
À peine vingt-quatre heures après la sortie publique de Claude Fable 5, le modèle de classe Mythos d’Anthropic, un benchmark indépendant de Berkeley RDI lui oppose un résultat contre-intuitif : c’est GPT-5.5 d’OpenAI, lancé en avril, qui occupe la première place du classement Agents’ Last Exam (ALE) avec un taux de réussite de 24,0 %, contre 22,0 % pour le nouveau modèle d’Anthropic. Plus frappant encore, la moyenne de l’ensemble des agents testés sur la tier la plus dure du benchmark ne dépasse pas 2,6 %.
Lancé le 9 juin 2026 et présenté sur la page officielle d’agenthle.org, ALE est issu du Center for Responsible, Decentralized Intelligence de l’Université de Californie à Berkeley, en collaboration avec un comité de plus de 300 experts de l’industrie issus notamment du MIT, Harvard, Stanford, Goldman Sachs, JPMorgan, Meta, Amazon, Adobe et Snorkel AI. Le projet a été déposé sur arXiv le 3 juin 2026 (identifiant 2606.05405) et distribue son jeu de données sous licence CC BY 4.0.
Un leaderboard qui rebat les pronostics
Le tableau publié par Agents’ Last Exam et reproduit par VentureBeat classe les cinq meilleurs harnais d’agents testés. Tous reposent sur des modèles déjà disponibles : aucun d’entre eux n’a été réentraîné pour l’occasion. La marge entre le premier et le dernier du top 5 n’est que de 3,6 points, ce qui suggère un benchmark exigeant plutôt qu’un examen trivial.
| Rang | Harnais | Modèle sous-jacent | Taux de réussite | Score moyen |
|---|---|---|---|---|
| 1 | Codex | gpt-5-5 | 24,0 % | 42,8 % |
| 2 | Ale Claw | gpt-5-5 | 23,0 % | 45,8 % |
| 3 | Claude Code | claude-fable-5 | 22,0 % | 40,5 % |
| 4 | OpenClaw | gpt-5-5 | 21,1 % | 41,0 % |
| 5 | Cursor CLI | composer-2-5 | 20,4 % | 38,5 % |
Top 5 des harnais d’agents au lancement d’ALE, juin 2026 — Source : UC Berkeley RDI / VentureBeat.
Trois des cinq configurations du top reposent sur GPT-5.5, ce qui tend à confirmer une observation de VentureBeat : OpenAI tient actuellement un avantage sur la stricte adhésion à des instructions multi-parties, là où l’architecture Claude est parfois jugée « oublieuse » au milieu d’un workflow long.
Une méthodologie conçue pour remplacer les benchmarks saturés
ALE part d’un constat documenté dans plusieurs audits indépendants récents : les benchmarks d’agents existants (SWE-Bench Pro, HumanEval, et apparentés) souffrent de deux maux — la contamination par les données d’entraînement et des correcteurs automatiques qui rejettent à tort des solutions correctes. La méthodologie d’ALE tente de refermer ces deux failles.
Le cadre d’évaluation, baptisé Generalist Computer-Use Agent (GCUA), décompose la capacité d’un agent en cinq couches fonctionnelles : Brain (raisonnement), Eyes (perception visuelle), Body (orchestration), Hands (invocation d’outils) et Feet (substrat d’exécution). L’agent doit mobiliser ses « yeux » et ses « mains » pour naviguer dans des machines virtuelles Linux ou Windows, en mêlant scripts shell et opérations pointer-cliquer dans des logiciels métiers lourds.
Sur le plan de la notation, l’équipe rejette presque entièrement le paradigme « LLM-as-a-judge », auquel elle ne confie que 6,8 % des workflows. Le reste passe par une évaluation déterministe, par code, qui compare l’artefact produit par l’agent à une référence experte — un mesh 3D, un rapport SEC, une image composée, etc.
Pour limiter la contamination, seule une fraction d’environ 10 % du jeu de données (environ 150 tâches) est rendue publique sur GitHub et Hugging Face. Les 1 300 autres tâches sont conservées privées, ce qui empêche les laboratoires d’optimiser directement leurs modèles sur les réponses.
Cinquante-cinq industries, 1 490 workflows réels
Les 55 sous-industries couvertes par ALE sont directement dérivées de la taxonomieTaxonomie Taxonomie désigne la branche fondamentale de la biologie qui a pour objet de décrire, de nommer et de classer les organismes vivants au sein d'un système hiérarchisé, en se basant… fédérale américaine O*NET / SOC 2018, qui décrit les métiers non-physiques. L’objectif assumé est de mesurer un impact sur le PIB, et non plus seulement des gains sur des casse-têtes isolés.
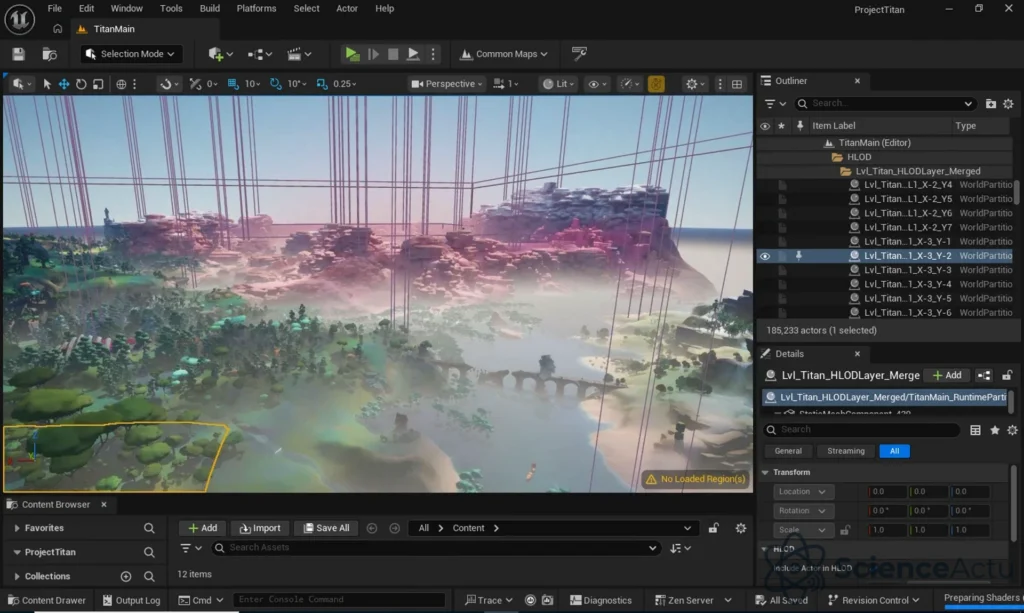
Au lancement, 1 490 instances de tâches sont disponibles, l’équipe visant 5 000 d’ici la fin de l’année. Chaque tâche est ancrée dans l’expérience quotidienne d’un praticien : créer un modèle 3D dans Siemens NX, configurer une scène dans Unreal Engine, segmenter une structure cérébrale dans FSLeyes, compositer un effet visuel dans Adobe After Effects, simuler un écoulement dans Moldex3D, ou modéliser un quartier en vue d’une analyse énergétique dans Rhino 3D.
Le benchmark est conçu comme un outil vivant : à mesure que de nouvelles industries et de nouveaux workflows émergent, de nouvelles tâches seront ajoutées, en s’éloignant définitivement des classements statiques. L’équipe promet aussi que les contributeurs experts pourront obtenir une co-signature sur les publications issues du projet.
Ce que le score de 2,6 % veut vraiment dire
Si le top 5 plafonne entre 20 et 24 %, la moyenne de l’ensemble des configurations testées sur la tier dite « Last-Exam » — la plus exigeante — ne dépasse pas 2,6 %, selon CryptoBriefing. La plupart des configurations y enregistrent un taux de réussite de 0,0 %, y compris Claude Opus 4.8 et la CLI Gemini de Google, plus anciens que les modèles de tête.
Le résultat n’est pas un désaveu de ces modèles : il rappelle qu’un agent conversationnel brillant sur des questions isolées peut s’effondrer dès qu’on lui demande d’exécuter, de bout en bout, un workflow professionnel vérifiable. Le signal corrobore les prévisions publiées par plusieurs cabinets au cours de l’année : l’écart entre un agent qui « sait répondre » et un agent qui « sait travailler » reste considérable, et c’est précisément ce deuxième régime qu’ALE ambitionne de mesurer.
Pour les laboratoires, la leçon est plus tactique que philosophique : sur des workflows longs et vérifiables, la discipline d’exécution d’un harnais (Codex, Ale Claw, OpenClaw) pèse autant, voire plus, que la simple puissance brute du modèle. Pour les entreprises, le score de 2,6 % sur la tier « Last-Exam » invite à relativiser les annonces marketing sur l’« autonomie des agents » — au moins jusqu’à ce que les modèles progressent sensiblement sur cette méthodologie exigeante.
Sources
- Agents’ Last Exam — AI Agent Benchmark for Real-World Professional Workflows — UC Berkeley RDI (page officielle du projet, juin 2026)
- Surprise upset: GPT-5.5 beats Claude Fable 5 on brutal new Agents’ Last Exam benchmark — VentureBeat, 10 juin 2026
- Agents’ Last Exam reveals AI agents struggle with real work tasks, passing just 2.6% of the time — CryptoBriefing, 10 juin 2026
- rdi-berkeley/agents-last-exam — Dépôt officiel GitHub (10 % public du dataset)
- arXiv:2606.05405 — Prépublication académique, soumise le 3 juin 2026







La discussion