








 Tech et IA
Chaque interaction avec un agent conversationnel semble immatérielle, une simple suite de caractères s’affichant sur un écran. Pourtant, derrière la fluidité de ces réponses se cache une réalité physique bien plus lourde : une dépense énergétique colossale qui commence à peser sur les infrastructures électriques mondiales. Si un chatbot ne transpire pas lorsqu’il rédige votre liste de courses ou invente une plaisanterie, la planète, elle, pourrait finir par en ressentir la chaleur.
- La consommation d’une requête varie selon la complexité du modèle, allant de l’équivalent d’une ampoule à celui d’un four domestique utilisé pendant une seconde.
- Les modèles de « raisonnement » consomment jusqu’à 70 fois plus de CO₂ que les modèles standards en raison de la génération massive de jetons internes.
- Le manque de transparence des leaders du secteur comme OpenAI entrave une évaluation précise de l’empreinte carbone globale de l’IA.
En juin dernier, Sam Altman, PDG d’OpenAI, affirmait qu’une requête « moyenne » sur ChatGPT consommait environ autant d’énergie qu’un four allumé pendant un peu plus d’une seconde. Si cette estimation rejoint les calculs de cabinets de recherche comme Epoch AI, les experts soulignent qu’elle manque cruellement de contexte. Qu’est-ce qu’une requête « moyenne » ? Pour Sasha Luccioni, chercheuse en IA et responsable climat chez Hugging Face, une telle simplification est trompeuse : « Si l’on veut être rigoureux, il faut donner une fourchette de valeurs. On ne peut pas se contenter de lancer un chiffre au hasard », explique-t-elle.
Pourquoi les modèles de langage sont-ils si gourmands en énergie ?
La voracité des grands modèles de langage (LLM) s’explique d’abord par leur architecture. On les définit souvent par leur nombre de paramètres, ces variables internes ajustées lors de l’apprentissage pour améliorer les performances. Plus un modèle possède de paramètres, plus il est capable de saisir des nuances complexes dans les données. GPT-4, par exemple, dépasserait le millier de milliards de paramètres. Comme le souligne Noman Bashir, informaticien au MIT, « pour assimiler l’ensemble des connaissances mondiales, il faut des modèles de plus en plus vastes ».
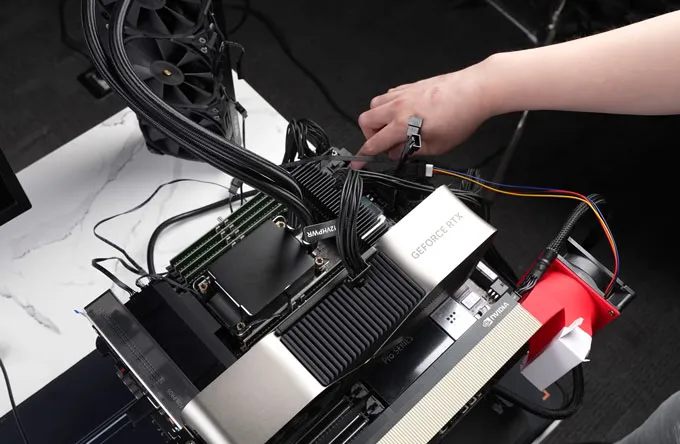
Ces modèles ne tournent pas sur un simple ordinateur portable, mais dans de gigantesques centres de données. Ils y sont chargés sur des serveurs équipés de processeurs graphiques ultra-puissants, les GPU de chez Nvidia, qui effectuent les calculs nécessaires pour générer une réponse en temps réel. Cette consommation énergétique de l’IA est déjà tangible : aux États-Unis, 4,4 % de l’électricité totale est absorbée par ces centres, un chiffre qui pourrait grimper jusqu’à 12 % d’ici 2028.
Les défis de la mesure de l’empreinte carbone de l’IA
Évaluer l’empreinte carbone IA est un exercice complexe qui se divise en deux phases distinctes. La première est l’entraînement : le modèle digère des volumes massifs de données pendant des semaines sur des milliers de GPU. Cette étape est une véritable « boîte noire » car les entreprises partagent rarement leurs méthodes ou la source d’énergie utilisée.
La seconde phase est l’inférenceInférence Inférence désigne, dans le contexte de l'intelligence artificielle, le processus opérationnel par lequel un modèle entraîné applique ses connaissances acquises à de nouvelles données inédites pour effectuer une prédiction, une…, c’est-à-dire chaque interaction entre un utilisateur et le modèle. À terme, c’est l’inférence qui représentera la majeure partie des émissions. « On entraîne un modèle une seule fois, mais des milliards d’utilisateurs s’en servent de façon répétée », note Mosharaf Chowdhury, informaticien à l’Université du Michigan. Cependant, l’impact d’une seule requête fluctue selon le centre de données sollicité, le mix énergétique du réseau local et même l’heure de la journée.
Modèles de raisonnement vs modèles standards : un coût énergétique décuplé
Face au secret industriel d’OpenAI ou d’Anthropic, les chercheurs se tournent vers les modèles open-source comme ceux de Meta ou DeepSeek. Une étude publiée dans Frontiers in Communication a analysé 14 de ces modèles et a révélé des disparités frappantes : certains émettent jusqu’à 70 fois plus de CO₂ que d’autres.
La différence majeure réside dans les modèles dits de « raisonnement ». Contrairement aux modèles standards qui fournissent une réponse directe, ces systèmes décomposent leur réflexion étape par étape. Ce processus génère une quantité massive de « jetons » (tokens), les unités de texte traitées par l’IA. À titre d’exemple, répondre à 500 000 questions avec le modèle DeepSeek R1 émettrait autant de CO₂ qu’un vol aller-retour entre Londres et New York.
Comment réduire l’impact environnemental de vos interactions avec l’IA
L’utilisateur final dispose de plusieurs leviers pour améliorer l’efficacité énergétique de ses usages. Le premier consiste à choisir le modèle adapté à la tâche. Est-il nécessaire de solliciter le modèle le plus lourd pour une question simple ? Des outils comme l' »AI Energy Score » de Hugging Face permettent désormais de comparer les modèles selon leur sobriété.
Enfin, le moment de la journée compte. Utiliser l’IA pendant les pics de demande estivale, quand les systèmes de refroidissement des centres de données tournent à plein régime, aggrave l’impact. Pour Sasha Luccioni, l’avenir passera nécessairement par une régulation : un système de notation énergétique, similaire à celui de l’électroménager, pourrait forcer les entreprises à optimiser leurs algorithmes. Sans une telle prise de conscience, la demande croissante de l’IA risque de se heurter violemment aux limites physiques de nos réseaux électriques.







La discussion