








 Tech et IA
GLM-5.2 : Z.ai muscle son agent de code avec une fenêtre d’un million de tokens
Sorti par Z.ai le 13 juin 2026, GLM-5.2 mise sur une fenêtre d'un million de tokens, deux modes d'effort de raisonnement et la licence MIT. Aucun benchmark public au lancement, mais un timing qui n'est pas anodin.
Sur quoi repose cet articleRapport
Type de travail
Rapport ou annonce
À garder en tête
Un rapport ou une annonce n’a pas été évalué par des pairs comme une étude publiée.
Z.ai a discrètement posé, le 13 juin 2026, un nouveau jalon dans la course aux modèles de fondation chinois. Le laboratoire, à l’origine de la lignée GLM, met à disposition GLM-5.2 avec une fenêtre de contexte d’un million de tokens, deux modes d’effort de raisonnement et une licence MIT. L’annonce intervient le jour même où l’administration américaine ordonne la suspension de Claude Fable 5 et Claude Mythos 5 — un timing que le fondateur Jie Tang n’a pas laissé passer sous silence.
Sur le papier, GLM-5.2 coche trois cases qui structurent l’année 2026 : la fenêtre d’un million de tokens désormais banalisée, le raisonnement configurable, et l’open source MIT comme posture industrielle. Mais le communiqué a aussi un angle mort : Z.ai n’a publié aucun benchmark public au lancement. Pour les observateurs techniques, c’est un signal à décoder plus qu’à célébrer.
Une fenêtre d’un million de tokens, vraiment utilisable
La spécification mise en avant est claire : un million de tokens en entrée, 131 072 tokens en sortie par réponse, sous la variante labellisée glm-5.2[1m]. C’est un saut d’un facteur cinq par rapport à GLM-5.1, dont la fenêtre tournait autour de 200 000 tokens. Pour un agent de code, l’écart n’est pas anodin : un référentiel de taille moyenne — code source, tests, configuration, historique de conversation — peut désormais tenir dans la mémoire de travail du modèle sans avoir à être compressé en boucle.
GLM-5.1 avait déjà montré qu’une fenêtre large, combinée à un effort de raisonnement soutenu, permettait de tenir environ 1 700 étapes d’agent en une session, soit jusqu’à huit heures d’autonomie sur des boucles « plan, exécuter, tester, corriger ». GLM-5.2 hérite de cette trajectoire, même si Z.ai n’a pas encore publié de chiffres propres pour la nouvelle version.
Deux modes d’effort de raisonnement
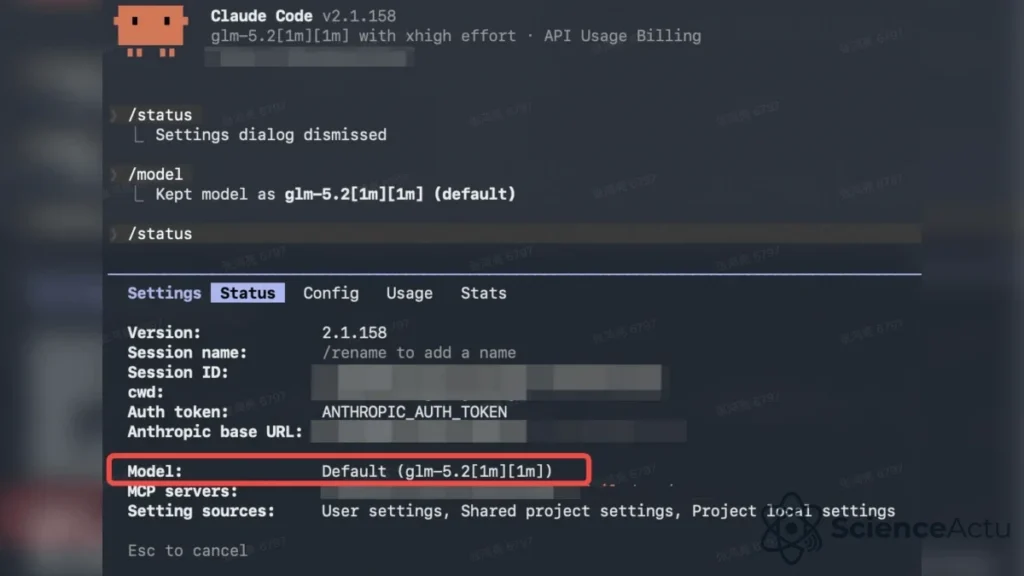
GLM-5.2 introduit un commutateur explicite : deux niveaux d’effort, High et Max. Pour les tâches de codage complexes et multi-étapes, Z.ai recommande Max, qui pousse le modèle à raisonner plus profondément avant de répondre. Dans Claude Code, ce réglage se pilote via la commande /effort : les options xhigh, max et ultracode mappent toutes vers le mode Max de GLM-5.2.
C’est un changement de philosophie opérationnelle : le modèle n’est plus un service monolithique, mais une pièce configurable. Le coût, la latenceLatence Latence désigne le délai temporel qui s'écoule entre le déclenchement d'une action et la survenue de son effet, correspondant souvent au temps nécessaire pour qu'une donnée transite d'un point source… et la profondeur de raisonnement deviennent des paramètres que l’utilisateur — ou l’orchestrateur d’agents — peut ajuster au cas par cas. Les autres laboratoires proposent déjà des mécanismes équivalents, mais l’implémentation par Z.ai a l’avantage d’être alignée sur les conventions déjà adoptées par Claude Code.
Pluie de versions dans la lignée GLM-5
La sortie de GLM-5.2 s’inscrit dans un tempo de release inhabituel. Sur quatre mois, Z.ai a publié :
- 11 février 2026 — GLM-5, première itération de la lignée.
- 15 mars 2026 — GLM-5-Turbo.
- 7 avril 2026 — GLM-5.1, avec poids ouverts et 58,4 sur SWE-bench Pro.
- 13 juin 2026 — GLM-5.2, fenêtre 1M et modes d’effort.
Quatre versions flagship en quatre mois, c’est un rythme qui rappelle davantage l’industrie des modèles chinois généralistes de 2025 que les cycles d’un laboratoire occidental. Cela traduit une stratégie assumée : itérer vite, garder la lignée en conditions réelles, et rendre publique chaque jalon pour entretenir l’élan communautaire.
Architecture : ce qui change et ce qu’on ne sait pas
Z.ai n’a pas détaillé l’architecture de GLM-5.2 dans ses matériaux de lancement. À titre de contexte, la base GLM-5 — toujours d’après des notes communautaires relayées par MarkTechPost — est un modèle de type Mixture-of-Experts (MoE) à 744 milliards de paramètres, activant 40 milliards de paramètres par token. GLM-5.1 gardait la même ossature avec un post-entraînement recentré.
Sans détail officiel, deux hypothèses sont ouvertes : GLM-5.2 reste sur la même base avec un nouveau pipeline d’instruction tuning, ou il introduit une variation structurelle non communiquée. Le poids total, la fenêtre d’attention, la méthode d’extension de contexte à 1M (position interpolation, sparse attention, autre) restent des inconnues techniques. Z.ai a promis la publication des poids sous licence MIT dans la semaine suivant l’annonce.
Ce que l’on ne sait pas encore
L’absence de benchmarks au lancement est l’élément le plus notable — et le plus prudent à interpréter. Pas de SWE-bench, pas de Terminal-Bench, pas de Code Arena publié. Pour un modèle qui se positionne sur le code agentique, c’est inhabituel : les versions précédentes, et la plupart des modèles concurrents, s’accompagnent de tableaux de scores dès l’annonce.
Trois lectures sont possibles. Premièrement, le modèle n’est pas encore stabilisé et Z.ai préfère corriger avant de publier. Deuxièmement, le labo a fait le choix marketing de mettre en avant la fenêtre, l’effort de raisonnement et l’ouverture, plutôt que les classements — un signal que l’avantage compétitif n’est plus dans la course au benchmark. Troisièmement, les chiffres viendront avec les poids ouverts, quand la communauté pourra les vérifier indépendamment. Les trois ne s’excluent pas.
Licence MIT et ouverture : un argument industriel
GLM-5.2 sera publié en open source MIT. Pour un modèle aux performances de pointe, c’est devenu un signal stratégique. La licence MIT autorise l’usage commercial sans copyleft, la redistribution et la modification, ce qui en fait la licence de référence pour les entreprises qui veulent intégrer un modèle souverain dans leur stack sans dépendance juridique.
Le fondateur de Z.ai, Jie Tang, a justifié ce choix en déclarant : « Le chemin vers l’AGI ne doit pas être entouré de hauts murs, l’humanité entière doit collaborer. Nous serons pleinement ouverts. » L’open source n’est plus seulement un argument de recherche : c’est un outil de positionnement dans un marché où l’accès aux modèles américains devient discontinu.
Un timing qui n’est pas anodin
Le 13 juin 2026, Anthropic annonce la suspension de Claude Fable 5 et Claude Mythos 5 sur ordre du gouvernement américain, à la suite de signalements d’accès par des groupes liés à la Chine. Le même jour, Z.ai publie GLM-5.2.
Jie Tang a relié explicitement les deux événements dans un message public : « La restriction soudaine de certains modèles frontière pour des raisons non techniques est profondément regrettable. À un moment où l’accès aux modèles frontière est brusquement coupé pour des raisons non techniques, nous sommes encore plus convaincus d’une chose : la science doit rester globale. » Le message est diplomatique, mais le calendrier ne l’est pas : un modèle de codage à fenêtre 1M, en open source MIT, annoncé le jour où deux modèles américains de pointe sont suspendus, parle de lui-même.
Reste à voir si l’écart de performance entre GLM-5.2 et la génération Fable/Mythos justifie un mouvement de fond chez les développeurs. Sans benchmarks publiés, la réponse viendra de l’usage réel et des retours communautaires, une fois les poids ouverts.
Compatibilité agentique : un choix d’outillage
GLM-5.2 est annoncé comme compatible avec huit outils agentiques dès le premier jour : Claude Code, Cline, OpenCode, OpenClaw, et d’autres. Le branchement se fait via un endpoint compatible Anthropic (https://api.z.ai/api/anthropic) ou OpenAI-compatible (https://api.z.ai/api/coding/paas/v4), avec un simple changement d’URL de base et d’identifiant de modèle.
Pour les utilisateurs de Claude Code, le code de configuration circule déjà : il suffit de pointer les slots Sonnet et Opus vers glm-5.2[1m] et de relever CLAUDE_CODE_AUTO_COMPACT_WINDOW à 1 000 000. Le modèle devient ainsi un drop-in replacement des modèles Anthropic dans un environnement familier, sans réécriture du harness d’agent.
Ce que cela change, en pratique
Trois usages concrets sont documentés par Z.ai et la presse technique. Pour un refactor de référentiel entier, un repo de taille moyenne tient dans la fenêtre sans aller-retour de résumé, ce qui réduit les erreurs de cohérence inter-fichiers. Pour les boucles agent long-horizon, l’héritage des 1 700 étapes de GLM-5.1 laisse espérer une marge supérieure, à confirmer en pratique. Pour l’analyse documentaire, des spécifications, logs ou transcripts dépassant 200K tokens peuvent être chargés d’un seul tenant au lieu d’être tronqués.
Pour les entreprises, l’attrait est double : un modèle de pointe en MIT, ouvert, utilisable derrière un endpoint auto-hébergeable ou via l’API Z.ai, sans dépendance exclusive à un fournisseur américain — alors même que l’accès à ces fournisseurs devient incertain. Pour les développeurs indépendants et les laboratoires académiques, l’open source promet une accessibilité immédiate aux poids, dès la semaine suivant l’annonce.
GLM-5.1 vs GLM-5.2 : ce qui change vraiment
| Caractéristique | GLM-5.1 | GLM-5.2 |
|---|---|---|
| Date de sortie | 7 avril 2026 | 13 juin 2026 |
| Fenêtre de contexte | ~200 000 tokens | 1 000 000 tokens (glm-5.2[1m]) |
| Sortie max par réponse | Non communiquée | 131 072 tokens |
| Modes d’effort | Mode unique | High / Max |
| Architecture | MoE 744B, 40B actifs | Non précisée au lancement (lignée GLM-5) |
| Licence | MIT, poids ouverts | MIT, poids ouverts prévus dans la semaine |
| Benchmarks au lancement | 58,4 SWE-bench Pro | Aucun publié |
| Accès au lancement | Coding Plan, API, poids | Coding Plan (Lite, Pro, Max, Team) — API et chatbot la semaine suivante |







La discussion