








 Tech et IA
Nemotron 3.5 Lightning : NVIDIA mise sur le routage pour ses agents IA
NVIDIA associe un modèle MoE orienté exécution à un routeur open source. Ce que ce duo change — et ce qu’il ne prouve pas encore — pour les agents IA.
Sur quoi repose cet articleRapport
Type de travail
Rapport ou annonce
À garder en tête
Un rapport ou une annonce n’a pas été évalué par des pairs comme une étude publiée.
NVIDIA ajoute Nemotron 3.5 Lightning à sa gamme de modèles ouverts avec une cible précise : les opérations répétitives d’un agent qui reste actif longtemps. Le modèle compte 30 milliards de paramètres, mais 3 milliards sont actifs à chaque token. Il est destiné aux appels d’outils, à la vérification de résultats et à la délégation de sous-tâches, plutôt qu’à la planification la plus complexe.
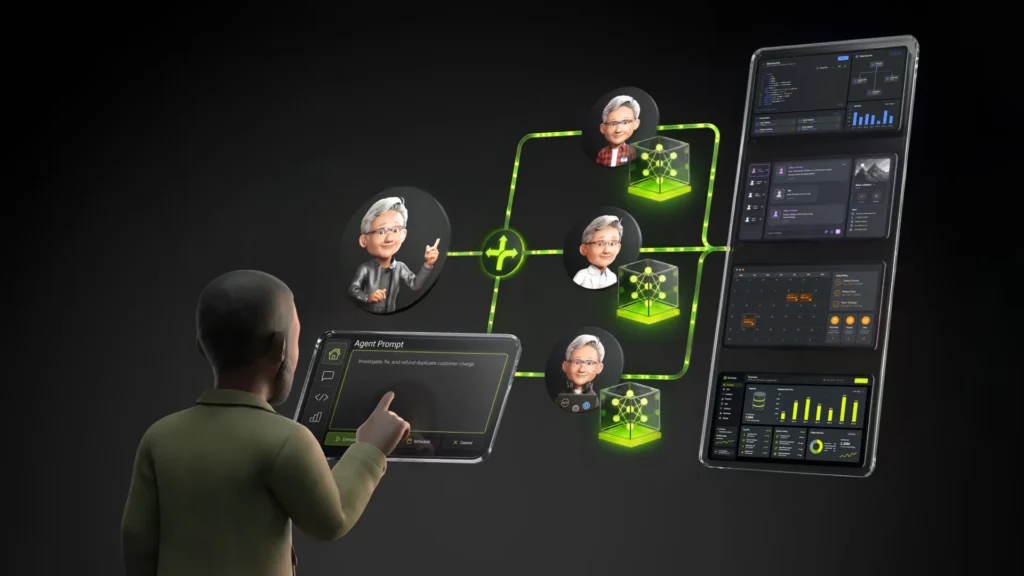
L’annonce s’accompagne de NeMo Switchyard, une bibliothèque open source de routage. Le duo illustre une évolution pratique : un agent n’est pas nécessairement servi par un seul modèle. Un modèle plus puissant peut préparer ou arbitrer une étape difficile ; un autre peut traiter le flux d’exécution courant.
Un modèle pour la couche d’exécution
Dans cette architecture, réduire le coût et la latenceLatence Latence désigne le délai temporel qui s'écoule entre le déclenchement d'une action et la survenue de son effet, correspondant souvent au temps nécessaire pour qu'une donnée transite d'un point source… des étapes routinières devient aussi important que la qualité du raisonnement. Le modèle est publié sous licence OpenMDW 1.1. Sa fiche technique annonce un contexte allant jusqu’à un million de tokens et un déploiement sur un seul DGX Spark ou H100. Ollama indique également sa disponibilité pour une exécution locale.
| Élément | Ce qui est documenté |
|---|---|
| Nemotron 3.5 Lightning | 30 Md de paramètres, 3 Md actifs ; modèle MoE ouvert |
| Rôle visé | Exécution d’outils et sous-tâches dans des agents persistants |
| NeMo Switchyard | Routage de requêtes entre modèles selon la tâche et les règles configurées |
| Accès | Fiche de modèle sur Hugging Face ; disponibilité annoncée dans Ollama |
Le routeur devient une pièce centrale
Switchyard évalue une requête et son contexte avant de l’orienter vers le modèle jugé approprié au regard des contraintes et des politiques définies par l’équipe. Le projet peut aussi conserver un état de routage pendant une session. Cela permet de changer de fournisseur ou de modèle sans réécrire toute l’intégration de l’agent, à condition de configurer et d’évaluer correctement les règles de routage.
Ce n’est pas une recette magique : NVIDIA reconnaît qu’un système de routage réellement prêt pour la production reste difficile à construire. La sélection d’un modèle pour une étape donnée dépend de la tâche, des données disponibles, des règles internes et du niveau de qualité attendu.
Des performances à lire comme des annonces
NVIDIA avance jusqu’à quatre fois plus de vitesse de sortie que des modèles ouverts comparables. L’entreprise indique aussi 86 % de précision sur PinchBench et un temps de réalisation de 10 000 tâches inférieur de 30 % à celui de Qwen3.6 35B à précision comparable. Ces résultats sont utiles pour comprendre le positionnement du modèle, mais ils proviennent du fournisseur : ils ne remplacent pas une évaluation indépendante sur le cas d’usage, les outils et le matériel d’une équipe.
La nouveauté la plus concrète est donc le partage du travail : réserver les modèles de raisonnement aux choix complexes, confier le volume aux modèles spécialisés, puis rendre cette répartition explicite et configurable. Pour les développeurs d’agents, le défi ne se limite plus à choisir un meilleur modèle ; il consiste à prouver que l’ensemble reste fiable quand les modèles, les outils et les tâches changent.







La discussion