








 Tech et IA
OmniGameArena : le benchmark qui teste les agents IA dans des jeux UE5
OmniGameArena propose douze jeux UE5 pour tester les agents IA visuels. Son intérêt : observer la progression et le transfert, pas seulement un classement instantané.
Sur quoi repose cet articleExplication
Type de travail
Article d’explication
À garder en tête
Une synthèse des connaissances : suivez les sources pour aller plus loin.
Au moins une source est une prépublication, pas encore relue par des pairs.
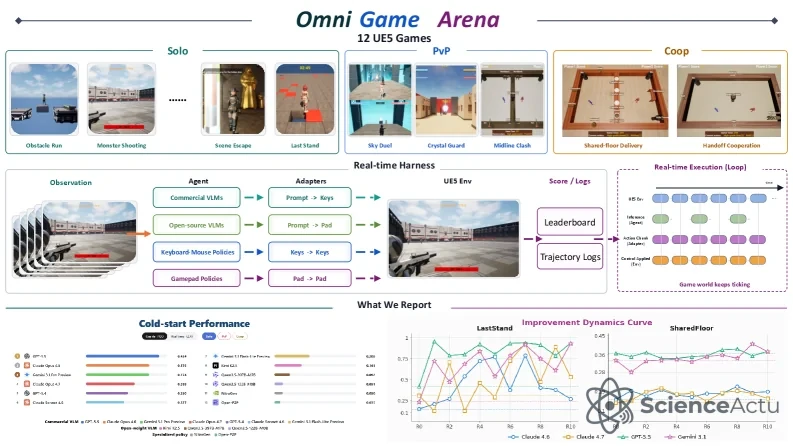
OmniGameArena ne lance pas un nouveau chatbot : il déplace la question vers la manière de juger les agents IA visuels. Ce preprint arXiv, publié le 8 juin 2026 et non relu par les pairs, propose un benchmark temps réel de douze jeux Unreal Engine 5 pour observer des agents VLM en action, avec une ambition précise : regarder non seulement leur score de départ, mais aussi leur capacité à progresser et à transférer une stratégie.
Le point clé : le benchmark combine sept jeux Solo, trois jeux PvP et deux jeux Coop, tous reliés par des interfaces d’action unifiées. L’ensemble vise à comparer des agents commerciaux, des modèles ouverts et des politiques spécialisées dans un cadre commun.
Ce que mesure vraiment OmniGameArena
Les jeux servent ici de laboratoire contrôlé pour des tâches qui mêlent perception visuelle, navigation spatiale, réaction, mémoire, planification, interaction adversariale et coopération. Les instances de jeu — règles, layouts, scripts et scoring — ont été créées pour le benchmark, afin de réduire le risque de contamination par des jeux publics déjà présents dans les données d’entraînement.
| Élément | Ce que cela apporte |
|---|---|
| 12 jeux UE5 | Un environnement visuel interactif au lieu d’un test textuel isolé. |
| 7 Solo, 3 PvP, 2 Coop | Des situations individuelles, adversariales et collaboratives. |
| Interfaces d’action unifiées | Une comparaison plus directe entre familles d’agents. |
| Variantes tenues à l’écart | Un test de transfert après apprentissage d’une stratégie. |
L’idée la plus intéressante : suivre la progression, pas seulement le classement
Le dispositif IDC, pour Improvement Dynamics Curve, ajoute une couche d’évaluation dynamique. Un LLM réflecteur outillé affine un prompt de compétence borné sur plusieurs tours. Deux signaux deviennent alors visibles : l’évolution du score au fil des tours et le comportement de la compétence apprise sur des variantes non vues.
Cette distinction est importante pour les agents IA. Un bon score initial peut masquer une faible capacité d’adaptation; une progression sur une tâche d’origine peut aussi ne pas se transférer correctement. Dans les résultats présentés, le leadership varie selon les jeux, aucun VLM ne domine partout, et l’amélioration sur la tâche d’origine ne suffit pas à prédire le transfert vers des variantes tenues à l’écart.
Pourquoi ce signal arrive au bon moment
Deux autres preprints récents pointent le même problème de fond : les agents IA sont de plus en plus jugés par des métriques qui doivent être interprétées avec prudence. Evaluation Cards souligne que les résultats d’évaluation sont présentés de façon incohérente entre leaderboards, model cards, papiers de benchmark et blogs d’entreprise, ce qui complique les comparaisons et la traçabilité des affirmations.
FASE, centré sur la qualité du code dans des systèmes multi-agents, rappelle de son côté que les hallucinations et la propagation d’erreurs peuvent fragiliser des chaînes d’agents. Sur HumanEval et BigCodeBench, FASE affiche une amélioration moyenne de 25 % de la corrélation de Spearman, une hausse de 19 % de ROCAUC contre Pass@1 et environ 0,3 % du coût d’exécution des approches traditionnelles de semantic entropy, avec le modèle Qwen3-Embedding-8B.
Ce qu’il faut surveiller avant d’en faire une référence
OmniGameArena reste un preprint. Ses résultats doivent donc être lus comme une proposition d’évaluation et non comme un verdict définitif sur les meilleurs agents visuels. L’intérêt scientifique immédiat se situe plutôt dans la méthode : faire apparaître les trajectoires d’amélioration, les écarts entre tâches d’origine et variantes, et les limites d’un simple classement instantané.
Pour les développeurs et les entreprises qui regardent les agents capables d’agir dans des interfaces visuelles, ce type de benchmark pose une question plus utile que « quel modèle est premier ? » : quel agent apprend une procédure exploitable, la garde en mémoire de travail et la réutilise quand l’environnement change ?







La discussion