








 Tech et IA
Jalapeño : OpenAI dévoile son premier accélérateur d’inférence, conçu avec Broadcom et déployé au gigawatt
Sur quoi repose cet articleRapport
Type de travail
Rapport ou annonce
À garder en tête
Un rapport ou une annonce n’a pas été évalué par des pairs comme une étude publiée.
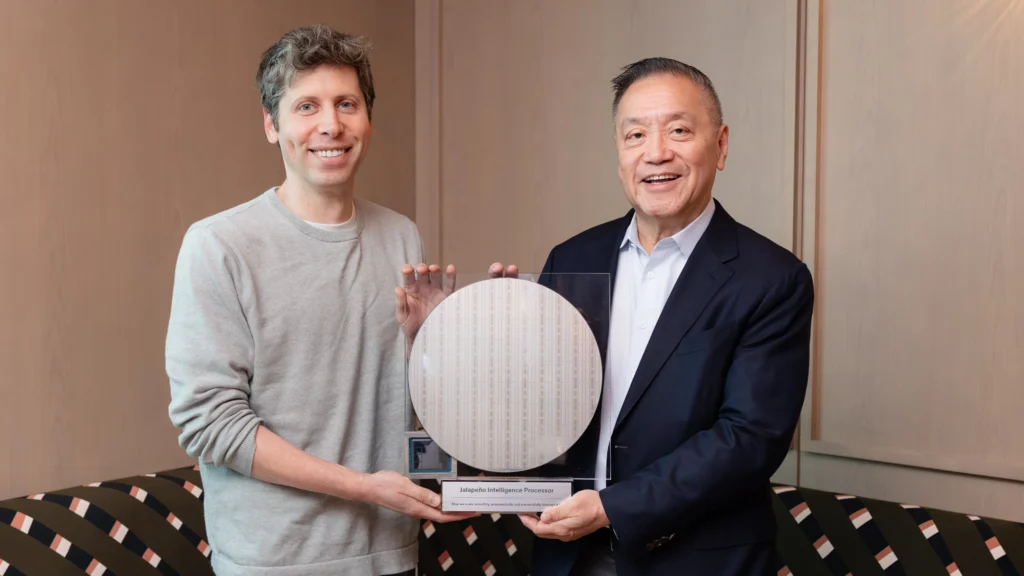
Le 24 juin 2026, OpenAI et Broadcom ont présenté Jalapeño, le premier accélérateur d’inférenceInférence Inférence désigne, dans le contexte de l'intelligence artificielle, le processus opérationnel par lequel un modèle entraîné applique ses connaissances acquises à de nouvelles données inédites pour effectuer une prédiction, une… conçu en interne par le laboratoire. Cette puce marque une étape importante : pour la première fois, OpenAI met sur le marché un silicium dont elle a elle-même défini l’architecture, avec Broadcom en partenaire industriel et Celestica pour l’intégration système. C’est un ASIC pensé dès la conception pour exécuter des grands modèles de langage (LLM), et non un GPU polyvalent reconverti.
L’annonce rapproche OpenAI d’une stratégie dite « full-stack » : modèles, produits, et désormais infrastructure physique. « Le monde se dirige vers une économie dopée au calcul », a déclaré Greg Brockman, président et cofondateur d’OpenAI. « Jalapeño s’inscrit dans notre stratégie d’infrastructure full-stack à long terme, destinée à rendre le calcul plus abondant, et donc l’IA plus rapide, plus fiable et plus abordable. »
Le pari industriel est double. D’un côté, OpenAI cherche à desserrer sa dépendance aux GPU Nvidia pour la phase d’inférence, comme l’avaient déjà fait Google avec ses TPU et Amazon avec Trainium et Inferentia. De l’autre, le laboratoire veut reprendre la main sur la couche matérielle pour mieux l’aligner avec ses propres modèles — un alignement que le calendrier de neuf mois entre design initial et tape-out rend possible, selon l’entreprise, uniquement parce que ses propres modèles d’IA ont contribué à accélérer certaines étapes de conception et d’optimisation.
Un ASIC blanc-slate, conçu pour l’inférence LLM
Jalapeño n’est pas un GPU d’usage général reconverti à l’IA : OpenAI le décrit comme un « blank-slate design for modern LLM inference ». L’architecture a été optimisée pour les kernels, les mouvements de mémoire, le networking et les patterns de service qui pèsent le plus dans l’exécution des modèles frontière, explique Richard Ho, qui dirige le programme matériel d’OpenAI : « Nous optimisons l’architecture autour des kernels, du data movement, du networking et des patterns de serving qui comptent le plus pour les modèles frontière. D’après les tests préliminaires, Jalapeño exécutera nos charges les plus importantes au plus près des limites théoriques du matériel. »
Concrètement, l’architecture « réduit les mouvements de données et équilibre les ressources de calcul, de mémoire et de networking pour obtenir une utilisation effective bien plus proche du pic théorique », indique le billet d’OpenAI. La mise en réseau s’appuie notamment sur le silicium Tomahawk de Broadcom, déjà largement déployé dans les data centers hyperscale.
La cible n’est pas l’entraînement. TechCrunch, qui a couvert l’annonce, le souligne : « Jalapeño est spécifiquement conçu pour l’inférence, c’est-à-dire le processus qui consiste à exécuter des modèles d’IA pré-entraînés en réponse à des requêtes. Dans son annonce, OpenAI a mis en avant le faible coût d’exploitation de la puce lorsqu’elle fait tourner des modèles de code en temps réel. » Le pré-entraînement, lui, continuera de reposer largement sur le matériel Nvidia, plus adapté aux charges massivement parallèles.
Neuf mois du design à la production, boostés par les modèles d’OpenAI
Le calendrier de développement fait partie des éléments les plus commentés de l’annonce. « Jalapeño a été co-développé du design initial jusqu’au tape-out de fabrication en seulement neuf mois, et le programme d’accélérateur IA personnalisé représente ce que nous croyons être le cycle de développement ASIC le plus rapide jamais réalisé dans les semi-conducteurs avancés à haute performance », écrit OpenAI. Ce rythme est le fruit d’une co-conception logicielle-matérielle approfondie avec les équipes d’ingénierie d’OpenAI, de l’expertise d’implémentation silicium de Broadcom, et de l’utilisation des modèles d’OpenAI pour accélérer certaines étapes de design et d’optimisation.
Les échantillons d’ingénierie fonctionnent déjà en laboratoire, à fréquence et puissance cibles, et font tourner des charges de machine learning — y compris GPT-5.3-Codex-Spark, le modèle dédié au code temps réel cité dans le communiqué d’OpenAI. Il ne s’agit donc pas d’une puce sur planchette : des workloads réels s’exécutent déjà dessus. OpenAI prévient néanmoins qu’un rapport technique détaillé sur les performances sera publié « dans les mois à venir » ; les chiffres définitifs — performance par watt, latenceLatence Latence désigne le délai temporel qui s'écoule entre le déclenchement d'une action et la survenue de son effet, correspondant souvent au temps nécessaire pour qu'une donnée transite d'un point source…, débit, prix — ne sont pas encore communiqués.
Une plateforme multi-génération, déployée au gigawatt avec Microsoft
Jalapeño est explicitement présenté comme la première étape d’une feuille de route « multi-génération », combinant les accélérateurs conçus par OpenAI avec l’implémentation silicium, le networking et les technologies de connectivité de Broadcom, et l’expertise cartes, racks et systèmes de Celestica. Le déploiement démarrera à l’échelle du gigawatt avec Microsoft et d’autres partenaires à partir de 2026, a précisé Hock Tan, président-directeur général de Broadcom : « Notre collaboration avec OpenAI représente un engagement fondamental à scaler l’infrastructure physique requise pour la prochaine décennie de l’IA. »
Ce partenariat avec Microsoft n’est pas anodin : il formalise l’intégration de Jalapeño dans la couche d’inférence qui sert déjà ChatGPT, l’API et les produits agentiques d’OpenAI. À terme, l’objectif est de fermer la boucle entre modèle et matériel. Comme l’écrit OpenAI, « OpenAI ne se contente pas de développer des modèles frontière ou de construire des produits par-dessus : elle conçoit l’infrastructure en dessous — architecture de puce, kernels, systèmes mémoire, networking, scheduling, déploiement et expérience produit. En opérant à travers toute la pile, chaque couche peut être optimisée pour le même objectif : rendre ses modèles plus rapides, plus fiables et plus abordables. »
L’inférence, nouveau poste de coût numéro un des LLM en production
Derrière l’annonce industrielle, il y a une lecture économique claire : à mesure que les modèles deviennent plus performants, l’inférence — c’est-à-dire le coût de servir chaque requête — devient le premier poste de dépense des opérateurs de LLM. L’entraînement est ponctuel et concentré dans quelques centres hyperscale ; l’inférence, elle, s’exécute en continu pour des millions d’utilisateurs de ChatGPT, d’outils d’API et désormais d’agents autonomes comme Codex.
Un accélérateur dédié, optimisé pour les kernels et les patterns de service d’un modèle précis, peut comprimer ce coût marginal par token. C’est la logique qu’avait adoptée Google avec ses TPU dès 2015, et qu’Amazon pousse avec Trainium (entraînement) et Inferentia (inférence). OpenAI entre aujourd’hui dans la même course, avec un silicium conçu par ses propres équipes et un partenaire industriel capable de le produire à l’échelle.
La distinction avec un GPU polyvalent n’est pas qu’un détail technique. Un ASIC d’inférence, rappelle la définition de Wikipedia d’un accélérateur d’IA (ou NPU, neural processing unit), est « une classe de hardware spécialisé conçu pour accélérer les applications d’intelligence artificielle et de machine learning », avec des compromis architecturaux orientés vers l’efficacité énergétique et le débit — au prix d’une polyvalence moindre. C’est précisément ce compromis qu’OpenAI choisit aujourd’hui, en assumant de ne pas viser le pré-entraînement avec cette première génération.
Ce qu’il faudra surveiller dans les mois à venir
- Le rapport technique annoncé par OpenAI : il livrera les premiers benchmarks officiels (performance par watt, latence, débit) et permettra une comparaison directe avec les Nvidia H100/B200 et les TPU de Google.
- Les détails matériels : nœud de fabrication, mémoire, bande passante d’interconnect, surface de die. Aucune de ces informations n’a été communiquée le 24 juin.
- L’ampleur réelle du déploiement chez Microsoft : le terme « gigawatt » est une cible, pas un fait. Le nombre exact de data centers concernés et le calendrier de mise en service détermineront l’impact effectif sur les coûts d’inférence d’OpenAI.
- L’évolution des prix et la dynamique du marché : un ASIC verticalement intégré peut à la fois réduire la facture d’inférence d’OpenAI et rebattre les cartes du rapport de force avec Nvidia, qui reste le fournisseur dominant des GPU d’entraînement.
- Les autres annonces majeures du secteur : Mistral, Anthropic et Google disposent déjà de leurs propres accélérateurs (TPU, Trainium). La question est de savoir qui, dans la prochaine vague, emboîtera le pas d’OpenAI avec un ASIC conçu en interne.
Pour l’instant, Jalapeño reste un pari sur le long terme : la puce n’est pas encore en production de masse, ses performances définitives ne sont pas publiques, et son déploiement à l’échelle du gigawatt avec Microsoft reste un objectif industriel. Mais la trajectoire est claire : l’infrastructure matérielle devient, après les modèles et les produits, le troisième pilier de la stratégie d’OpenAI.
Sources
- OpenAI — OpenAI and Broadcom unveil LLM-optimized inference chip (24 juin 2026)
- TechCrunch — OpenAI unveils its first custom chip, built by Broadcom (24 juin 2026, Russell Brandom)
- OpenAI — OpenAI and Broadcom announce strategic collaboration (octobre 2025)
- Wikipedia — AI accelerator (Neural processing unit)







La discussion