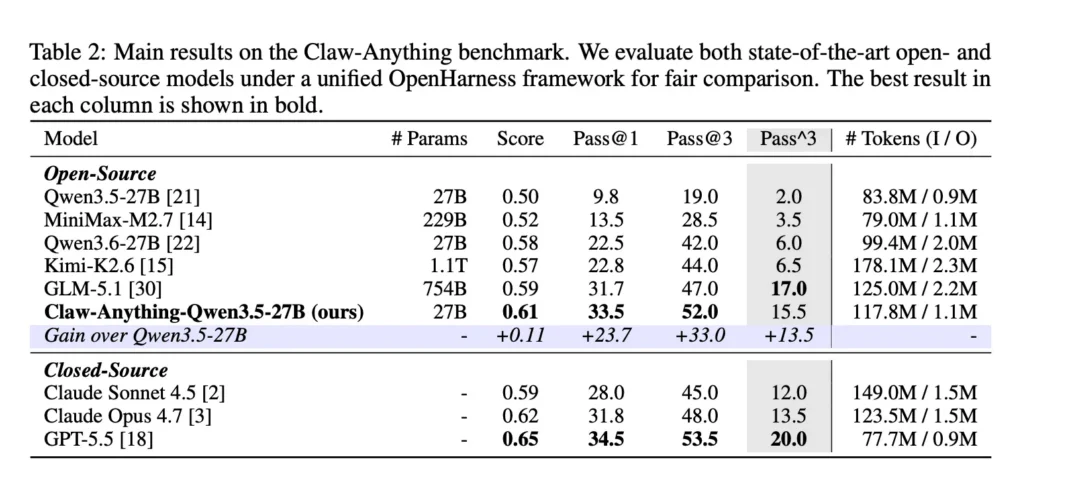
Un nouvel indicateur rappelle que la promesse des agents IA personnels reste très loin d’être réglée. Dans le préprint Claw-Anything: Benchmarking Always-On Personal Assistants with Broader Access to User’s Digital World, des chercheurs associés à Huawei et à plusieurs partenaires proposent d’évaluer des assistants capables de naviguer dans un environnement numérique beaucoup plus proche du quotidien réel : historique long, services interconnectés, ordinateur, téléphone, interface graphique et ligne de commande. Le résultat central est volontairement inconfortable : même un modèle de pointe annoncé dans l’étude, GPT-5.5, n’obtient que 34,5 % en pass@1 sur ce test.
Il faut lire ce score avec prudence : il s’agit d’un préprint arXiv, donc d’un travail public mais pas nécessairement relu par les pairs. Il n’en reste pas moins intéressant, car Claw-Anything vise précisément une zone aveugle de l’évaluation actuelle. Les agents modernes savent résumer un document, appeler un outil, modifier un fichier ou enchaîner quelques actions dans un navigateur. Mais un véritable assistant personnel devrait comprendre un contexte mouvant, contradictoire, accumulé sur plusieurs semaines, puis agir sans casser l’environnement de l’utilisateur.
Ce que Claw-Anything change dans la manière de tester les agents
La plupart des benchmarks d’agents exposent un problème bien délimité : une page web, une application, quelques fichiers, un objectif à atteindre. Claw-Anything élargit le décor. Selon le papier, l’environnement simule des mois d’activité utilisateur grâce à des injections d’événements successives. Les agents doivent alors raisonner dans un monde numérique encombré : informations utiles, bruit, signaux contradictoires, dépendances entre services et actions possibles sur plusieurs appareils.
C’est une différence importante. Dans la vie réelle, une demande simple — par exemple préparer un déplacement, retrouver une décision ancienne, coordonner un rendez-vous ou recommander une action proactive — dépend rarement d’une seule source. Elle peut impliquer des e-mails, un calendrier, des documents, des préférences, des notifications et des applications qui ne racontent pas exactement la même histoire. Claw-Anything cherche donc moins à mesurer la brillance linguistique d’un modèle qu’à tester sa capacité à tenir un fil d’exécution dans un environnement personnel large.
À retenir : le benchmark ne demande pas seulement à l’IA de répondre correctement. Il l’oblige à agir comme un assistant « toujours actif », avec accès à davantage d’éléments du monde numérique simulé de l’utilisateur. C’est précisément là que les erreurs de contexte, de coordination et de sécurité deviennent plus visibles.
Un score de 34,5 % qui relativise le discours marketing
Le chiffre le plus commenté est le pass@1 de 34,5 % attribué à GPT-5.5 dans l’étude. En clair, sur une tentative unique, le modèle échoue dans environ deux cas sur trois selon les critères du benchmark. Des médias spécialisés comme Decrypt et Crypto Briefing ont repris ce résultat pour souligner l’écart entre la promesse commerciale des assistants autonomes et leur fiabilité dans des contextes réalistes.
Ce n’est pas forcément une contradiction avec les progrès récents. Un agent peut très bien réussir des tâches courtes, produire du code utile ou manipuler des outils simples, tout en devenant fragile lorsqu’il doit relier plusieurs services, interpréter un historique long et choisir une action au bon moment. Le papier insiste justement sur ce point : les évaluations trop étroites peuvent donner une impression de maîtrise qui ne se transfère pas automatiquement vers un assistant personnel toujours connecté.
L’un des éléments les plus parlants vient de la taille du contexte. Decrypt rapporte que les tâches de Claw-Anything mobilisent en moyenne un volume de contexte très supérieur à celui de nombreux tests existants, avec des environnements simulant plus de trois mois d’activité et de nombreux services interconnectés. Cette densité change la nature du problème : il ne s’agit plus seulement de « savoir » répondre, mais de sélectionner les bonnes traces dans une mémoire numérique bruyante.
Pourquoi les agents échouent : coordination, mémoire et sécurité
La difficulté principale n’est pas seulement le raisonnement abstrait. Elle tient à la coordination. Un assistant utile doit comprendre qu’une information dans un calendrier peut contredire un e-mail plus ancien, qu’une préférence de l’utilisateur peut limiter une action techniquement possible, ou qu’une recommandation proactive peut devenir intrusive si elle repose sur une interprétation fragile. Plus l’agent dispose d’accès, plus l’erreur coûte cher.
C’est là que Claw-Anything devient intéressant pour les développeurs d’agents. Le benchmark ne dit pas seulement « les modèles sont faibles ». Il suggère que l’architecture autour du modèle compte autant que le modèle lui-même : mémoire, journalisation des actions, séparation des permissions, capacité à demander confirmation, évaluation de l’incertitude et récupération après erreur. Un assistant personnel ne peut pas être seulement un chatbot branché à des API.
Le papier mentionne aussi un pipeline de génération de données. Les auteurs indiquent avoir produit 2 000 environnements d’entraînement, et rapportent qu’un ajustement d’un modèle open weight sur des trajectoires d’agents réussies améliore la réussite de 23,7 %. Ce point est à double lecture. D’un côté, il montre que de meilleures données d’interaction peuvent aider. De l’autre, il confirme que les performances actuelles ne sont pas naturellement robustes dès que l’on élargit le terrain de jeu.
Une leçon pour les assistants IA grand public
Pour les utilisateurs, Claw-Anything invite à distinguer trois niveaux d’autonomie. Le premier est l’assistance conversationnelle : résumer, expliquer, rédiger. Le deuxième est l’action outillée : créer un événement, lancer une recherche, modifier un document. Le troisième est l’assistance personnelle durable : comprendre un contexte sur la durée, anticiper un besoin, coordonner plusieurs services et éviter les actions dangereuses. C’est ce troisième niveau que le benchmark met sous pression.
Cette distinction compte aussi pour les entreprises. Beaucoup d’organisations testent aujourd’hui des agents capables d’agir dans des environnements internes : support informatique, analyse de tickets, développement logiciel, finance, conformité. Les résultats de Claw-Anything rappellent qu’un bon score sur une tâche isolée ne suffit pas à autoriser une autonomie large. Avant de donner à un agent des accès réels, il faut mesurer sa fiabilité dans des scénarios longs, vérifier ses journaux d’action et limiter ce qu’il peut faire sans validation humaine.
Le sujet est également réglementaire et éthique. Un assistant toujours actif peut devenir utile précisément parce qu’il voit beaucoup de choses : messages, habitudes, documents, appareils, préférences. Mais cette même visibilité augmente les risques de confidentialité, d’erreur irréversible et de surinterprétation. Le papier reconnaît ces risques et présente Claw-Anything comme un outil d’évaluation, non comme une preuve que de tels agents devraient être déployés sans garde-fous.
Ce qu’il faut surveiller maintenant
La prochaine étape ne sera probablement pas un unique modèle miracle. Les progrès viendront plutôt d’une combinaison : modèles plus capables, environnements de test plus réalistes, données de trajectoires mieux contrôlées, agents capables d’expliquer leurs actions, et mécanismes de sécurité intégrés dès la conception. Les benchmarks comme Claw-Anything, Open Agent Leaderboard ou les tests d’agents en environnement IT montrent une tendance commune : l’ère des agents se jouera sur la fiabilité opérationnelle, pas seulement sur l’éloquence des modèles.
Pour ScienceActu, l’intérêt durable de Claw-Anything est donc moins son classement ponctuel que son cadrage scientifique. Il rappelle que l’IA agentique doit être évaluée dans des mondes complexes, avec du bruit, des dépendances et des permissions. C’est seulement à cette condition que l’on saura si les assistants IA deviennent réellement des copilotes du quotidien — ou s’ils restent des outils impressionnants, mais encore trop fragiles pour gérer seuls notre vie numérique.
Sources
- Préprint arXiv — Claw-Anything: Benchmarking Always-On Personal Assistants with Broader Access to User’s Digital World
- Decrypt — présentation du benchmark Claw-Anything
- Crypto Briefing — analyse des limites des agents IA personnels
- Dépôt GitHub Claw-Anything
- Jeu de données Claw-Anything sur Hugging Face