








 Tech et IA
Qwen-Robot Suite : quand Alibaba apprend à ses modèles à agir dans le monde physique
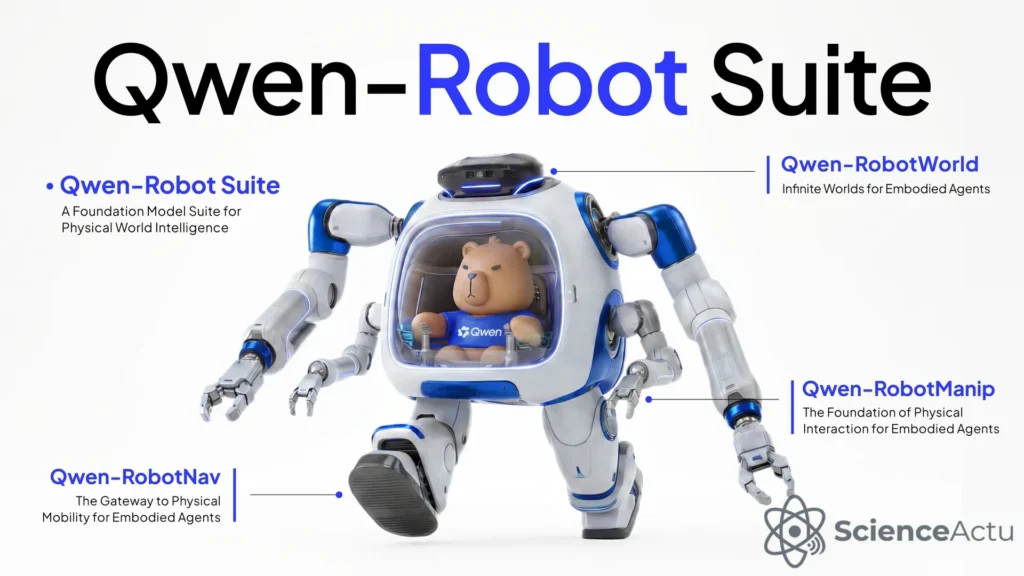
Le 16 juin 2026, Tongyi Lab, la division recherche d'Alibaba, a publié la Qwen-Robot Suite, une famille de trois modèles dédiée à la robotique et pilotée par le langage naturel. L'annonce cumule navigation, manipulation et modèle du monde, et s'inscrit dans une course à l'IA incarnée où Physical Intelligence, Google DeepMind et NVIDIA avancent en parallèle.
Sur quoi repose cet articleRapport
Type de travail
Rapport ou annonce
À garder en tête
Un rapport ou une annonce n’a pas été évalué par des pairs comme une étude publiée.
Le 16 juin 2026, Tongyi Lab, la division recherche d’Alibaba, a publié la Qwen-Robot Suite, sa première famille de modèles d’IA dédiée aux robots physiques. Le découpage est inhabituel : là où un fournisseur de modèles classique livre une seule API généraliste, Tongyi Lab expose trois modèles spécialisés — Qwen-RobotNav pour la navigation, Qwen-RobotManip pour la manipulation, Qwen-RobotWorld pour la prédiction du monde physique — articulés autour d’un pilotage en langage naturel et d’un planificateur de haut niveau, Qwen3.7-Plus, qui les appelle comme des outils. La publication coïncide, à trois jours près, avec la suspension de Claude Fable 5 et Mythos 5 aux États-Unis, ce qui n’est pas anodin : en 2026, le terrain de jeu de l’IA de pointe se déplace du chatbot vers l’agent qui agit dans le monde réel, et la Chine comme les États-Unis commencent à y engager des modèles dédiés.
L’annonce est documentée par un billet technique de 13 minutes publié sur le blog officiel Qwen le 15 juin, par Reuters le 16 juin, et par plusieurs médias francophones et anglophones (Korben, 01net, Clubic, SCMP, Pandaily, ForkLog). C’est la première fois qu’un acteur chinois de l’IA de fondation propose un ensemble aussi structuré de modèles pour la robotique, et c’est aussi l’un des rares cas où l’éditeur publie, dans le même billet, les choix d’architecture et les résultats détaillés sur six benchmarks robotiques de référence.
Pourquoi trois modèles et pas un seul ?
La question revient dans la plupart des commentaires grand public : pourquoi ne pas simplement réutiliser un grand modèle de langage, comme Qwen3.7-Plus, pour piloter un robot ? Le billet technique de Qwen donne une réponse précise. « Comprendre le monde physique, ce n’est pas y agir », écrivent les chercheurs : un modèle de vision-langage comme Qwen-VL peut planifier une tâche en langage (« va dans la cuisine, trouve la tasse rouge, prends-la et pose-la sur l’étagère »), mais il ne sait pas produire les commandes motrices qui exécutent la trajectoire. Le problème, expliquent-ils, est un problème d’alignement : les instructions en langage et les signaux d’action physique vivent dans des espaces de représentation différents, et les données nécessaires pour combler ce fossé sont hétérogènes par nature.
Une trajectoire de navigation, une saisie télé-opérée et une vidéo de dashcam ne partagent ni le même format d’observation, ni le même espace d’action, ni la même morphologie de robot. Les empiler naïvement produit du conflit plutôt que de la synergie. C’est pour cela que Tongyi Lab a choisi de découper le problème en trois sous-modèles, chacun alignant le langage avec un domaine d’action spécifique, et de les faire converger par un orchestrateur de haut niveau.
RobotNav, RobotManip, RobotWorld : à quoi servent les trois briques
Qwen-RobotNav est la brique mobilité. Construit sur Qwen3-VL et entraîné sur 15,6 millions d’échantillons, il unifie cinq familles de tâches : instruction following, object-goal navigation, target tracking, conduite autonome et EQA (question-réponse sur environnement). La nouveauté tient à un protocole d’observation paramétrable : le modèle expose comme paramètres le budget de tokens visuels, la décroissance temporelle, le poids par caméra et le mode d’échantillonnage d’image. Ce sont ces paramètres que l’orchestrateur peut changer à la volée, sans réentraînement, pour adapter la stratégie d’observation au type de tâche en cours.
Qwen-RobotManip est la brique interaction. Construit sur Qwen3.5-4B VL avec un action head DiT flow-matching, il ramène les gestes de manipulation à un espace canonique de 80 dimensions, partagé entre bras unique, bras double, main dexterous et bras mobile. Les actions sont exprimées en delta-pose de l’effecteur dans le repère caméra, ce qui rend numériquement proches des mouvements visuellement similaires sur des morphologies différentes. Le modèle est entraîné sur plus de 38 100 heures de données entièrement open source : 11 320 heures de données robot, 1 933 heures de vidéo humaine en vue subjective, et 24 808 heures de démonstrations robot générées par un pipeline « humain-vers-robot » qui synthétise des données pour 15 morphologies différentes.
Qwen-RobotWorld est la brique imagination. C’est un modèle de monde entraîné conjointement sur plus de 20 morphologies de robots, en utilisant le langage naturel comme interface d’action : au lieu de produire des commandes bas niveau, il prédit des futurs physiquement plausibles à partir d’instructions en langage. C’est ce module qui permet, dans les démonstrations publiques, à un robot quadrupède Unitree Go2 de naviguer dans un appartement jamais vu et de revenir à son point de départ en suivant des consignes vocales successives.
Les benchmarks annoncés, et ce qu’ils mesurent vraiment
Les chiffres publiés sur le blog Qwen placent la suite en tête sur plusieurs benchmarks reconnus, mais tous les chiffres présentés sont des chiffres de l’éditeur, sans validation indépendante rendue publique. Voici ce qui est annoncé, en gardant à l’esprit cette limite.
| Modèle | Benchmark | Score annoncé | Référence citée |
|---|---|---|---|
| RobotNav | VLN-CE RxR | 76,5 % SR | état de l’art annoncé |
| RobotNav | HM3Dv2 object-goal (RGB only) | 75,6 % SR | surpasse les méthodes basées profondeur |
| RobotNav | EVT-Bench tracking | 90,0 % | état de l’art annoncé |
| RobotNav | NAVSIM (conduite) | 91,4 PDMS | variante 4B |
| RobotManip | LIBERO-Plus | 91,4 % (+7,0 vs π0.5) | vs Physical Intelligence |
| RobotManip | RoboChallenge Table30 v1 | #1 (45 % SR, 59,83 process) | 20 % devant le 3e |
Scores publiés dans le billet officiel Qwen du 15 juin 2026. Aucun n’a, à ce jour, été répliqué publiquement par un laboratoire tiers. Source : blog Qwen / Tongyi Lab.
Deux points méritent d’être soulignés. D’une part, Qwen-RobotManip annonce un écart de 7 points sur LIBERO-Plus face à π0.5, le modèle de Physical Intelligence : c’est l’écart le plus important parmi ceux revendiqués. D’autre part, le score de 45 % sur RoboChallenge Table30 v1, dans la catégorie « généraliste », place le modèle 20 % au-dessus du troisième — un fossé inhabituel sur ce type de classement, où les marges sont traditionnellement étroites. Tant que ces résultats n’auront pas été répliqués sur des plateformes publiques, la prudence reste de mise.
Un système agentique à deux niveaux
La Qwen-Robot Suite n’est pas seulement une collection de trois modèles. Elle est conçue pour être appelée comme une boîte à outils par un modèle de planification de haut niveau, en l’occurrence Qwen3.7-Plus, le modèle de fondation propriétaire d’Alibaba sorti en mai 2026. Le planificateur décompose un objectif long terme en sous-tâches, choisit à la volée quel mode de RobotNav utiliser, et maintient une mémoire à deux niveaux (court terme et long terme) qui lui permet d’enchaîner des instructions sur plusieurs minutes sans perdre le fil.
Sur EXPRESS-Bench, un benchmark de raisonnement long terme en environnement, l’équipe revendique un gain de +15,4 % par rapport au meilleur système précédent, avec 77 % d’étapes de navigation en moins. Ce résultat n’est pas qu’un effet de mode : il suggère que la décomposition explicite entre planification et exécution, plutôt qu’un gros modèle généraliste, pourrait être la voie la plus efficace pour les agents qui doivent agir dans la durée. La même intuition structure d’ailleurs les travaux récents sur le tooling en LLM : sortir la « cognition » du chemin critique permet de réduire le coût et d’augmenter la fiabilité.
La course à l’IA incarnée en 2026
L’annonce d’Alibaba s’inscrit dans une séquence où plusieurs acteurs cherchent explicitement à marier modèles de fondation et robotique. Physical Intelligence, jeune pousse californienne fondée par d’anciens chercheurs de Google DeepMind, a publié π0 puis π0.5, sur lequel Alibaba revendique une avance. Google DeepMind a lancé Gemini Robotics, qui couple un modèle Gemini à des action heads spécialisés. NVIDIA pousse GR00T, son modèle fondation pour robots humanoïdes, intégré à la pile Isaac. Côté chinois encore, Xiaomi a publié MiMo Code pour le code agentique, mais sa branche robotique reste en retrait public. Tencent, selon le South China Morning Post, travaillerait également sur des modèles pour l’embodied AI.
Ce que la Qwen-Robot Suite ajoute à ce tableau, c’est un découpage explicite entre trois compétences et un planificateur en langage naturel, le tout publié sous une politique open source. Reuters, dans son cadrage du 16 juin, résume le mouvement en une formule : la tech chinoise « passe du chatbot à l’agent qui exécute des tâches complexes et rend les machines plus intelligentes ». Pour la presse tech francophone, le moment est même qualifié de « moment Android » de la robotique : un cerveau logiciel standardisé que n’importe quel fabricant de bras, de roues ou de drones pourrait embarquer.
Ce qu’on ne sait pas encore
Trois inconnues pèsent sur l’annonce. Premièrement, les poids et la licence open source : l’équipe promet une diffusion des trois modèles dans la foulée, mais au moment de la rédaction, le calendrier exact n’est pas public. Tant que la communauté ne peut pas faire tourner les modèles sur son propre matériel, les benchmarks annoncés restent difficiles à reproduire.
Deuxièmement, la maturité industrielle. La démo Chat2Robot, accessible en navigateur, ne tourne que sur 50 tâches et n’est « pas parfaite » selon la propre formulation de l’éditeur. Le pilote est annoncé chez quelques clients d’Alibaba Cloud, sans liste publique ni méthodologie divulguée. Pour les cas d’usage réels — entrepôt, usine, assistance à la personne — il faudra attendre des retours d’usage indépendants.
Troisièmement, la généralisation hors morphologies vues. Les démos publiques utilisent un quadrupède Unitree Go2 et des bras robotiques. Le billet technique annonce des résultats sur 15 morphologies pour RobotManip et plus de 20 pour RobotWorld, mais ne précise pas dans quelle mesure les poids ouverts fonctionneront sur des plateformes matérielles qu’Alibaba n’a pas elle-même testées.
Reste un point de méthode : Alibaba ne vend pas de robot, mais le « cerveau » qui va dedans. Si la stratégie open source porte ses fruits — comme elle l’a fait pour la famille Qwen, massivement adoptée par les développeurs — la Qwen-Robot Suite pourrait devenir, d’ici la fin 2026, une brique de base pour des projets de robotique qui n’auraient pas les moyens d’entraîner leurs propres modèles. C’est probablement l’enjeu réel de cette annonce, au-delà des scores sur benchmarks.
Sources
- Qwen-Robot Suite: A Foundation Model Suite for Physical World Intelligence — blog officiel Qwen / Tongyi Lab, 15 juin 2026 (publication primaire, 13 min de lecture, contient les choix d’architecture, les chiffres de benchmark et les démonstrations citées dans l’article)
- Alibaba unveils AI models for robots, amid shift from chatbots to agents — Reuters, 16 juin 2026
- Qwen-Robot Suite — Alibaba donne un corps à son IA — Korben, 18 juin 2026
- Le géant chinois Alibaba dévoile des IA conçues pour animer des robots intelligents — 01net, 16 juin 2026
- Alibaba prépare l’après-chatbot avec une nouvelle génération d’IA — Clubic, 17 juin 2026
- Alibaba Releases Qwen-Robot Series, Its First Embodied AI Model Family — Pandaily, 17 juin 2026
- Qwen-RobotNav: The Gateway to Mobility for Physical Agents — billet technique officiel, 15 juin 2026
- Qwen-RobotManip: The Foundation of Physical Interaction — billet technique officiel, 15 juin 2026







La discussion