OpenAI a présenté, le 30 juin 2026, GeneBench-Pro, un nouveau benchmark destiné à mesurer la capacité des modèles d’IA à exécuter de vraies analyses en biologie computationnelle — pas à réciter des faits ni à appliquer un pipeline prédéfini. Le résultat le plus parlant n’est pas le score absolu : GPT-5.6 Sol résout 31,5 % des problèmes en mode Pro, contre 16,0 % pour Claude Opus 4.8 et 3,1 % pour Gemini 3.1 Pro. L’écart entre les modèles de pointe est large, et aucun ne franchit la barre du tiers des 129 tâches.
Pour la première fois, un acteur de premier plan livre une évaluation déterminée — c’est-à-dire notée contre une vérité de terrain connue — de ce que les agents scientifiques savent réellement faire dans un domaine où la variabilité des datasets historiques rendait jusqu’ici les comparaisons presque impossibles. Le pari est méthodologique autant que technique.
Ce que mesure GeneBench-Pro, et pourquoi les benchmarks précédents ne suffisaient plus
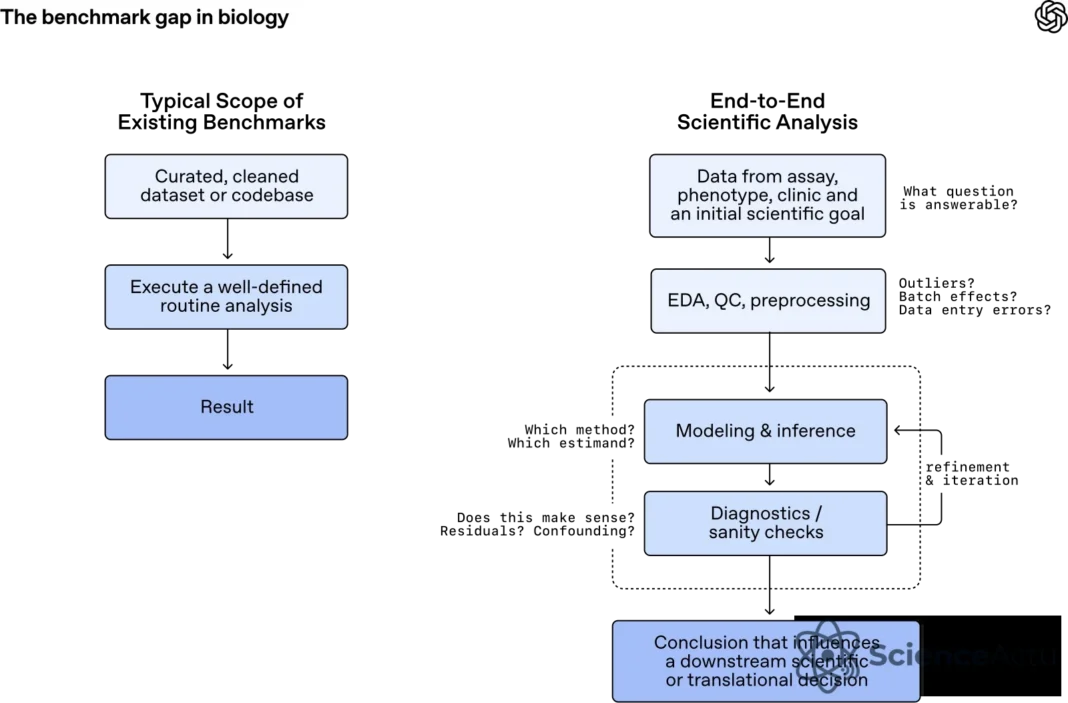
La plupart des benchmarks IA en biologie testent la mémorisation de connaissances ou l’exécution d’une étape isolée : un modèle sait-il nommer un gène, reconnaître une structure protéique, exécuter un pipeline SNP ? GeneBench-Pro exige autre chose. Chaque problème donne à l’agent un dataset réaliste et volontairement bruité, un contexte expérimental court, et un estimand cible — une grandeur numérique qu’une décision clinique ou de recherche viendrait consommer en aval. L’agent doit explorer les données, identifier des défauts de qualité (échantillons mal étiquetés, biais d’ascendance, artéfacts d’ADN ancien), choisir une approche analytique, itérer quand le plan initial ne tient plus, et rendre une réponse numérique dans un format contraint.
OpenAI résume ce qu’il cherche à mesurer sous le terme research taste — l’enchaînement de jugements qui distingue un biologiste computationnel expérimenté d’un novice qui sait exécuter un script. C’est, d’après les auteurs, la compétence qui limite aujourd’hui le plus l’autonomie des agents IA en laboratoire, bien plus que la maîtrise d’un outil ou la capacité à suivre une procédure connue.
Une construction qui cherche à neutraliser les biais classiques
GeneBench-Pro s’attaque frontalement à deux défauts bien identifiés des benchmarks de longue durée en biologie. Le premier est la soumission à l’arbitraire de l’auteur : sur des jeux de données historiques, deux chemins analytiques également défendables peuvent produire deux notes, et la “bonne” note reflète surtout le choix du créateur du benchmark. Le second est l’insensibilité numérique : un problème trop large peut être réussi par un agent qui se trompe lourdement, simplement parce que la métrique ne discrimine pas les erreurs.
La méthode adoptée par OpenAI est techniquement explicite : chaque problème est généré synthétiquement à partir d’une structure causale connue, ce qui permet de noter déterministiquement les réponses contre une vérité de terrain, de tuner la difficulté, et de vérifier par ablation que les analyses plausibles mais incorrectes échouent. Les auteurs ont aussi envoyé 82 des 129 problèmes à des experts externes — doctorants, post-doctorants, chercheurs industriels et professeurs d’institutions comme UCLA, le New York Genome Center ou la société Gencove — pour valider le réalisme, la pertinence des méthodes attendues et l’absence de raccourcis exploitables. Un audit de fuite d’information et de solutions non intentionnelles a également été mené.

Ce que les chiffres disent vraiment
Les résultats publiés brossent un paysage plus contrasté que ce que les communiqués laissent entendre. Le tableau ci-dessous compile les taux de réussite communiqués sur GeneBench-Pro (mode raisonnement le plus élevé) et, à titre de comparaison, le score du modèle sur le précédent GeneBench quand il est connu.
Scores comparés sur GeneBench-Pro
- GPT-5.6 Sol (Pro) — 31,5 % sur GeneBench-Pro ; 33,2 % sur l’ancien GeneBench en mode xhigh.
- GPT-5.6 Sol — 28,7 % sur GeneBench-Pro (sans Pro).
- GPT-5.2 — près de six fois moins de problèmes résolus que GPT-5.6 Sol, pour environ deux tiers des tokens consommés à haut niveau de raisonnement.
- Claude Opus 4.8 (Anthropic) — 16,0 %, meilleur score non-OpenAI sur GeneBench-Pro.
- Gemini 3.1 Pro (Google) — 3,1 %.
Deux lectures coexistent. La lecture optimiste : passer de moins de 5 % (GPT-5, début du développement de GeneBench) à 31,5 % en quelques mois représente une progression nette, et le scaling du temps d’inférence reste un levier efficace — à bas niveau de raisonnement, GPT-5.6 Sol tombe à un score à un chiffre. La lecture prudente : deux tiers des problèmes restent hors de portée des modèles généralistes actuels, et la dynamique de progression n’a pas encore atteint le rythme qui rendrait l’agent autonome crédible en laboratoire.
L’écart GPT vs Claude : ce que la biologie révèle que le code ne montre pas
L’équipe GeneBench-Pro note un signal intéressant : l’écart entre GPT-5.6 Sol, GPT-5.5 et les meilleurs modèles open source comme GLM 5.2 (Z.ai) est, sur ce benchmark, nettement plus large que ce que les benchmarks de code laissaient prévoir. Le pattern est inverse à celui qu’on observe sur les évaluations centrées ingénierie logicielle (SWE-Bench, DeepSWE), où les modèles open source ont comblé une partie du retard. En biologie computationnelle, la pile agentique fermée reste devant, et l’écart se creuse quand on monte en exigence de raisonnement.
Ce résultat a deux implications concrètes. D’une part, les benchmarks de code sous-estiment la distance restante entre modèles généralistes et scientifiques autonomes : un agent bon en ingénierie logicielle ne devient pas automatiquement bon en analyse de variants génétiques. D’autre part, le research taste — la capacité à choisir une méthode et à reconnaître quand un résultat n’est pas publiable — semble rester une compétence où les modèles entraînés sur de très grandes quantités de traces de raisonnement scientifique conservent un avantage structurel.
Là où les agents échouent encore : observer sans intégrer
Les reviewers externes interrogés par OpenAI identifient un motif d’échec récurrent. Les modèles remarquent les anomalies dans les données — mesures incohérentes, ascendance mal attribuée, biais C>T en ADN ancien — mais ne savent pas en tirer les conséquences analytiques. Lex Flagel, directeur data science chez Gencove, résume : « la plupart des agents échouent à l’étape 2, c’est-à-dire à intégrer une observation dans une décision sur la suite de l’analyse ».
Ce profil d’échec — observer sans fermer la boucle inférentielle — reproduit, selon OpenAI, la différence entre experts humains et novices : les experts reformulent le problème et adaptent leur approche au fil de l’eau, là où les novices enchaînent des étapes sans les recadrer. Pour la communauté biotech, ce diagnostic est plus utile qu’un simple score : il pointe la couche de compétence à améliorer avant de parler d’agents autonomes en laboratoire.
Coût et accessibilité : le levier économique du benchmark
GeneBench-Pro inclut une dimension économique rarement présente dans les benchmarks scientifiques. Les reviewers externes ont estimé qu’un problème typique demande 20 à 40 heures de travail à un expert humain, à un taux conservateur de 200 $/h : plusieurs milliers de dollars par problème. OpenAI note que le coût d’inférence d’un agent actuel sur le même problème se chiffre en quelques dollars, avec un taux de réussite certes très inférieur, mais déjà non négligeable.
Pour la R&D industrielle, ce différentiel de coût ouvre un arbitrage inédit : même une automatisation partielle — disons 20-30 % de problèmes résolus de manière fiable — représente une accélération matérielle du cycle d’itération entre génération de données, triage d’hypothèses et validation de cibles. Le passage à un agent pleinement autonome n’est pas annoncé, mais l’assiette économique de l’automatisation partielle est déjà mesurable.
Ce qui est ouvert, ce qui reste fermé
OpenAI adopte une politique d’ouverture mesurée sur GeneBench-Pro. 10 questions représentatives sont publiées en open source sur Hugging Face, accompagnées de leurs cas d’étude publics. Un sous-ensemble de 50 questions sera confié à Artificial Analysis pour un benchmarking indépendant à venir — un choix méthodologique qui distingue GeneBench-Pro de nombreux benchmarks auto-administrés et qui permet à terme une lecture tierce des scores.
L’ensemble des 129 problèmes, lui, n’est pas ouvert en intégralité, pour des raisons de contamination — un benchmark public complet verrait ses scores s’éroder rapidement à mesure que les modèles s’y entraîneraient. Le compromis (10 + 50 + audits externes) cherche à rendre l’évaluation auditable sans la rendre exploitable comme corpus d’entraînement. OpenAI n’a, à ce stade, pas annoncé de modèle spécifiquement fine-tuné sur ce type de raisonnement scientifique, ni de tarification dédiée pour une telle spécialisation.
Ce qu’il faut en retenir pour la R&D biotech
GeneBench-Pro ne dit pas que les modèles généralistes sont prêts à remplacer des chercheurs en bioinformatique. Il dit qu’il existe désormais un instrument de mesure crédible pour savoir où ils en sont, et que cet instrument révèle un écart important entre les familles de modèles — un écart qui ne se voit pas dans les benchmarks de code.
Trois conséquences pratiques pour les équipes qui évaluent ou déploient des agents en sciences de la vie :
- Un bon score sur SWE-Bench ou sur des tests de tool-use ne garantit pas un bon score en analyse génomique réelle : tester sur un proxy de research taste avant déploiement.
- L’écart GPT-5.6 / Claude Opus 4.8 (≈ 2×) invite à maintenir plusieurs familles de modèles en évaluation continue, plutôt qu’à figer un fournisseur unique.
- Pour les fournisseurs d’agents et les éditeurs de plateformes biotech, la course à l’autonomie totale reste prématurée ; l’automatisation partielle — triage d’hypothèses, pré-QC, génération de pipelines candidats — est l’étape de produit immédiatement défendable.
Sources
- OpenAI — Introducing GeneBench-Pro (30 juin 2026)
- bioRxiv — GeneBench-Pro preprint, version 1 (29 juin 2026)
- Hugging Face — Genebench-Pro public package (10 questions ouvertes)
- Tech Times — OpenAI Genomics Benchmark: AI Judgment Gap Exposed in Research-Grade Tasks (2 juillet 2026)
- Silicon Report — OpenAI Introduces GeneBench-Pro, Benchmarking AI in Genomics and Biology (1er juillet 2026)