Le nouveau signal fort sur les agents IA ne vient pas d’un chatbot plus agréable ni d’un benchmark scolaire saturé. Il vient d’un test beaucoup plus ingrat : diagnostiquer des incidents Kubernetes à partir de journaux, d’alertes, de traces et de topologies d’infrastructure, comme le ferait une équipe SRE. C’est précisément l’objet de ITBench-AA, lancé le 27 mai par IBM Research et Artificial Analysis. Le constat est difficile à ignorer : selon les résultats publiés, même les meilleurs modèles ou agents évalués restent sous 50% sur cette première déclinaison orientée entreprise.
À retenir : le nouveau benchmark porte sur 59 tâches SRE liées à des incidents Kubernetes ; Claude Opus 4.7 mène à 47%, GPT-5.5 suit à 46% et Qwen3.7 Max à 42%, tandis que tous les modèles testés restent sous la barre des 50%. Le message central n’est pas qu’un acteur a gagné, mais que l’autonomie réelle des agents en environnement technique complexe reste beaucoup plus fragile que ne le suggèrent de nombreux démonstrateurs.
Ce que mesure exactement ITBench-AA
Le billet publié sur Hugging Face par IBM Research et Artificial Analysis présente ITBench-AA comme une implémentation d’évaluation fondée sur ITBench, un cadre plus large consacré à l’automatisation de tâches IT réelles. La déclinaison annoncée cette semaine commence par la Site Reliability Engineering : en pratique, l’agent doit inspecter un instantané d’incident Kubernetes, lire des logs, suivre des dépendances, repérer les entités impliquées et produire un diagnostic structuré.
Le point important est méthodologique. Il ne s’agit pas d’une simple question-réponse textuelle. D’après la documentation publiée, chaque tâche est résolue dans un harnais agentique open source, Stirrup, avec accès shell à un espace de travail sandboxé contenant les instantanés utiles. Le score affiché correspond ensuite à une précision moyenne à rappel complet : si l’agent oublie une cause racine attendue, il obtient zéro pour cette répétition ; s’il couvre toutes les causes, sa note dépend de la propreté de sa liste finale. Autrement dit, ce benchmark pénalise fortement les diagnostics partiels ou trop bavards.
Pourquoi la barre des 50% compte vraiment
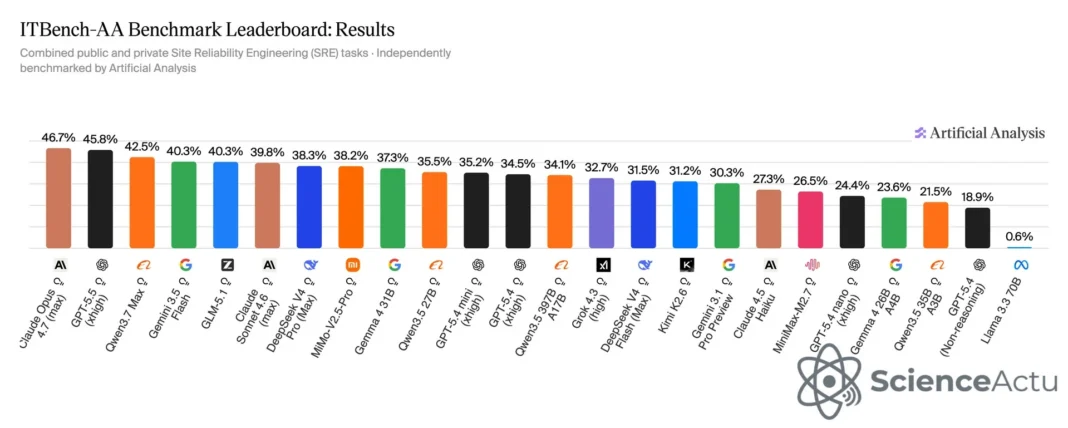
Dans les résultats mis en ligne le 27 mai, Claude Opus 4.7 mène à 47%, devant GPT-5.5 à 46% et Qwen3.7 Max à 42%. Côté modèles ouverts ou open weights, GLM-5.1 atteint 40%, DeepSeek V4 Pro 38% et Gemma 4 31B 37%. Ce n’est pas un effondrement total, mais c’est suffisamment bas pour casser un récit devenu courant : celui selon lequel les meilleurs agents seraient déjà proches d’une exploitation robuste sur des tâches d’exploitation système complexes.
L’intérêt éditorial de ce sujet est là. Dans les démos, les agents ont souvent l’air convaincants parce qu’ils réussissent des scénarios courts, des workflows bien guidés ou des tâches où l’on tolère une réponse approximative. ITBench-AA mesure autre chose : la capacité à isoler la vraie cause racine dans un environnement bruyant, multi-symptômes et riche en faux coupables possibles. C’est un test beaucoup plus proche de ce qui distingue un assistant impressionnant d’un outil réellement fiable pour des équipes techniques.
Ce que le benchmark dit aussi sur les limites actuelles des agents
Le billet souligne un résultat particulièrement intéressant : faire plus de tours ne garantit pas de meilleurs diagnostics. Au contraire, certains modèles qui enquêtent longtemps ajoutent des entités contributives ou des symptômes adjacents à la cause racine, ce qui leur coûte des points. Les auteurs donnent l’exemple de Gemini 3.1 Pro Preview, qui effectue en moyenne 83 tours pour environ 30%, là où des systèmes plus concis peuvent mieux s’en sortir.
Cette observation compte au-delà du benchmark lui-même. Elle rappelle qu’un agent autonome n’est pas seulement limité par ses connaissances, mais aussi par sa discipline d’enquête. Chercher plus longtemps, appeler plus d’outils ou accumuler davantage de contexte n’améliore pas forcément la qualité finale si le système ne hiérarchise pas correctement les causes, les signaux et les effets secondaires. Autrement dit, le problème n’est pas uniquement la puissance brute du modèle ; c’est aussi l’architecture de décision, la gestion du contexte et la manière de conclure.
Un benchmark plus crédible parce qu’il reste difficile
L’un des défauts récurrents de nombreux benchmarks IA est leur saturation rapide. Une fois les scores très hauts, ils distinguent mal les systèmes et perdent une partie de leur valeur prédictive. ITBench-AA semble pour l’instant échapper à ce problème. Les auteurs insistent d’ailleurs sur ce point en comparant ce nouveau test à d’autres évaluations agentiques plus favorables. Si tous les leaders restent sous 50%, c’est peut-être moins le signe d’un benchmark « injuste » que celui d’une tâche qui ressemble davantage à la complexité réelle du travail d’exploitation.
Il faut néanmoins lire ce signal avec prudence. ITBench-AA n’épuise pas toute la question des agents d’entreprise. Il se concentre d’abord sur la SRE et sur des instantanés d’incidents Kubernetes. Il ne dit pas, à lui seul, ce qu’un agent saura faire dans le support utilisateur, la conformité, la cybersécurité défensive ou l’automatisation documentaire. Mais il apporte une mesure précieuse sur un point souvent survolé : la différence entre résoudre un exercice et diagnostiquer un système.
Le contexte scientifique : ITBench existait avant ITBench-AA
Le benchmark annoncé cette semaine s’appuie sur un cadre plus ancien. Le dépôt officiel ITBench et le papier disponible sur arXiv décrivent une famille de tâches IT couvrant SRE, CISO et FinOps, avec un jeu initial de 94 scénarios réels ou inspirés de situations réelles. Il faut le préciser clairement : le papier arXiv est un preprint, donc à lire avec la prudence habituelle associée aux travaux non relus par les pairs au moment de leur diffusion. Mais il donne un contexte utile pour comprendre que l’annonce du 27 mai ne sort pas de nulle part : elle s’inscrit dans un effort plus large visant à mesurer des agents sur des tâches d’automatisation technique concrètes.
Ce lien entre papier, dépôt, harnais open source et tableau d’évaluation public renforce l’intérêt du sujet. On n’est pas seulement devant un communiqué marketing vantant un agent miracle. On a plutôt un nouveau point de référence pour observer où les systèmes échouent encore, combien ils coûtent par tâche, et comment différentes familles de modèles se comportent sur un problème bien circonscrit.
Pourquoi ce sujet compte pour les développeurs et les entreprises
Pour les équipes techniques, le message est assez simple : les agents progressent, mais ils ne sont pas encore des SRE autonomes fiables. Pour les entreprises, cela signifie que l’intégration d’agents dans des workflows d’exploitation doit rester encadrée, vérifiable et humaine dans les étapes critiques. Pour l’écosystème des modèles, cela rappelle que la compétition ne se joue plus seulement sur des benchmarks généralistes ou sur des démonstrations spectaculaires, mais sur des tâches professionnelles étroites où une erreur de diagnostic peut coûter du temps, de l’argent ou une panne prolongée.
Pour replacer ce lancement dans un cadre plus large, on peut aussi relire notre analyse de l’Open Agent Leaderboard. Là où ce précédent baromètre demandait déjà de juger des systèmes agents complets plutôt que de simples modèles, ITBench-AA pousse la logique un cran plus loin sur un terrain d’entreprise beaucoup plus rude. C’est sans doute la vraie nouveauté : l’évaluation des agents commence enfin à quitter les vitrines pour entrer dans les zones où leur fiabilité se mesure vraiment.
- Fait publié : ITBench-AA SRE couvre 59 tâches, dont 40 publiques et 19 tenues à l’écart pour l’évaluation.
- Fait publié : le harnais Stirrup donne à l’agent un accès shell à un espace sandboxé contenant logs, traces et instantanés d’incident.
- Fait publié : la note dépend d’une précision moyenne à rappel complet, ce qui pénalise fortement les diagnostics incomplets ou pollués de faux positifs.
- Fait publié : Claude Opus 4.7 mène à 47%, devant GPT-5.5 à 46% et Qwen3.7 Max à 42%.
- Lecture prudente : ces chiffres ne disent pas qu’un modèle est “meilleur partout”, mais qu’aucun n’est encore proche d’une fiabilité tranquille sur cette tâche précise.
Le papier ITBench cité pour le contexte est diffusé sur arXiv : il apporte un cadre utile, mais doit être lu comme un preprint. L’annonce du 27 mai, elle, porte sur la mise en ligne d’un benchmark d’évaluation public et sur des résultats comparatifs associés.