Liquid AI, la jeune pousse américaine spin-off du MIT CSAIL, a présenté le 25 juin son plus petit modèle de fondation à ce jour : LFM2.5-230M, un modèle de 230 millions de paramètres taillé pour les workflows agentiques qui s’exécutent entièrement sur l’appareil — du smartphone au Raspberry Pi, du robot humanoïde au serveur embarqué. Sur deux benchmarks ciblés (extraction de données et tool use), il surpasse des modèles trois à quatre fois plus gros, dont l’Alibaba Qwen3.5-0.8B et le Google Gemma 3 1B. C’est moins une anecdote de compression qu’un signal sur l’état de l’architecture LFM2 et, plus largement, sur la maturité d’une voie alternative au transformer pur pour l’IA embarquée.
Ce qui sort le 25 juin
Le modèle est disponible immédiatement sur Hugging Face, en base et en version post-entraînée, avec un support jour-1 dans l’écosystème d’inférence open source : llama.cpp (GGUF), MLX, vLLM, SGLang et ONNX, selon VentureBeat qui a couvert la sortie en avant-première. La société publie également la recette d’inférence officielle vLLM, ce qui confirme l’intégration immédiate dans les stacks de production.
Comme le résume Crypto Briefing, l’enjeu n’est pas de battre les modèles phares sur des benchmarks généralistes, mais de faire tourner, sur un téléphone ou une carte à 60 dollars, des workflows structurés qui dépendaient jusqu’ici d’un appel API à plusieurs dollars le million de tokens. Le pari industriel est différent du pari technique habituel : il s’agit de déplacer l’inférence du cloud vers la périphérie.
230 millions de paramètres, et alors ?
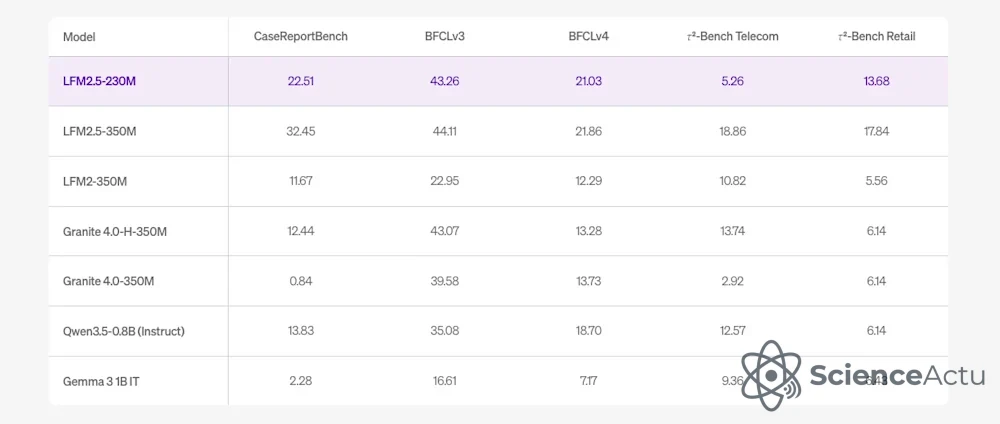
Pour situer l’ordre de grandeur, voici les scores publiés par Liquid AI et repris par VentureBeat et Crypto Briefing sur deux benchmarks d’extraction et d’utilisation d’outils. Les chiffres plus élevés sont meilleurs.
| Modèle | Paramètres | BFCLv3 (tool use) | CaseReportBench (extraction) |
|---|---|---|---|
| LFM2.5-230M (Liquid AI) | 230 M | 43,26 | 22,51 |
| Granite 4.0-350M (IBM) | ~350 M | 39,58 | non publié |
| Qwen3.5-0.8B Instruct (Alibaba) | 800 M | non publié | 13,83 |
| Gemma 3 1B IT (Google) | 1 000 M | 16,61 | 2,28 |
Le contraste est particulièrement net sur CaseReportBench : à nombre de paramètres quasi divisé par quatre, LFM2.5-230M fait près de dix fois mieux que Gemma 3 1B (22,51 contre 2,28) et 1,6 fois mieux que Qwen3.5-0.8B (22,51 contre 13,83). Sur BFCLv3, l’écart avec Gemma 3 1B est encore plus tranché (43,26 contre 16,61). Ces scores sont publiés par Liquid AI et n’ont pas, à ce stade, fait l’objet d’une vérification indépendante mentionnée dans les sources consultées ; la prudence méthodologique reste de mise.
Ce qu’il faut comprendre en une phrase. Sur des tâches très structurées (extraction de champs, appels d’outils), un petit modèle bien conçu peut écraser des modèles trois à quatre fois plus gros — ce n’est pas une question de puissance brute mais d’adéquation entre architecture, données d’entraînement et cas d’usage.
Ce qui change vraiment : l’architecture LFM2
La différence ne tient pas aux chiffres mais à la recette. LFM2.5-230M s’appuie sur l’architecture LFM2 dévoilée par Liquid AI l’an passé, un système hybride qui alterne des convolutions courtes à portes (gated short-range convolutions) et de l’attention groupée (grouped-query attention), selon VentureBeat. L’idée, partagée avec d’autres approches efficaces type Hyena ou StripedHyena, est de gérer les dépendances locales sans payer le coût quadratique de l’attention pure sur les longues séquences.
Pour un lectorat non spécialiste, deux points suffisent à saisir l’enjeu :
- dans un transformer classique, chaque token « regarde » tous les autres tokens de la fenêtre — ce qui explose en mémoire et en calcul quand la fenêtre grandit ;
- dans LFM2, les courtes convolutions captent les patterns très locaux (syntaxe, mise en forme), tandis que l’attention groupée ne sert qu’à orchestrer des blocs plus longs — d’où une empreinte mémoire inférieure à 400 Mo et une fenêtre de contexte de 32 000 tokens qui reste gérable sur du matériel embarqué.
Ce mélange n’est pas gratuit : sur les tâches généralistes (rédaction longue, raisonnement mathématique avancé, code complexe), Liquid AI reconnaît que son modèle n’est pas conçu pour rivaliser avec les grandes classes de paramètres. La société assume un positionnement de complément, pas de remplacement frontal.
Ce que ça change concrètement : du téléphone au Raspberry Pi
Les chiffres de cadence publiés par VentureBeat donnent une idée du saut pratique :
- 213 tokens par seconde en decode sur un Samsung Galaxy S25 Ultra (Qualcomm Snapdragon Gen4) ;
- 42 tokens par seconde en decode sur un Raspberry Pi 5, la carte mono-ordinateur à 60 dollars environ ;
- empreinte mémoire inférieure à 400 Mo, ce qui laisse de la marge sur des terminaux contraints.
Pour une entreprise qui doit extraire des champs d’une facture, normaliser des adresses ou router de la télémétrie, la différence économique est massive. VentureBeat prend un exemple parlant : faire appel à Claude Opus 4.6 pour parser une facture (à 5 dollars le million de tokens d’entrée) n’a aucun sens économique ; un modèle local capable de tenir 42 tokens par seconde sur une carte à 60 dollars, oui.
Pourquoi ce point compte. À ce niveau de coût d’inférence, la frontière entre « IA dans le cloud » et « IA dans l’appareil » ne se joue plus seulement sur la qualité des réponses, mais sur la maîtrise du budget et de la latence. Pour des flottes de capteurs, des terminaux de point de vente ou des robots mobiles, le calcul change.
La robotique humanoïde comme banc d’essai
La démonstration la plus parlante, rapportée par VentureBeat, concerne la robotique. Liquid AI a déployé LFM2.5-230M sur un robot humanoïde Unitree G1, en s’appuyant sur le module de calcul embarqué NVIDIA Jetson Orin et sur le framework SONIC de NVIDIA. L’expérience montre que le modèle reçoit une instruction en langage naturel libre — par exemple « reste immobile 2 secondes, avance à 1 m/s pendant 3 m, agenouille-toi sur une jambe pendant 5 s, puis recule à 0,5 m/s pendant 3 m » — et la traduit automatiquement en une séquence structurée d’appels aux skills de bas niveau fournis par SONIC.
Ce qui est intéressant n’est pas la cascade d’instructions en soi, mais le fait qu’elle se fasse entièrement sur le robot, sans connexion réseau. Pour un humanoïde qui doit réagir en temps réel à un environnement changeant, la latence et la confidentialité de l’inférence locale ne sont pas un confort : elles sont une condition opérationnelle. C’est précisément ce que ce format de modèle compact rend possible.
Pourquoi ce détail compte. La robotique humanoïde est le banc d’essai le plus exigeant pour un modèle edge : budget mémoire réduit, contraintes temps réel, impératif de confidentialité. Une démonstration qui passe ces trois filtres vaut plus qu’un benchmark synthétique.
Licence et écosystème : qui peut vraiment l’utiliser
LFM2.5-230M est distribué sous la LFM Open License v1.0, une licence « dual-use » qui n’est pas reconnue comme open source par l’Open Source Initiative, détaille VentureBeat. Concrètement : pour les développeurs indépendants, les chercheurs et les startups générant moins de 10 millions de dollars de chiffre d’affaires annuel, la licence fonctionne à l’identique d’une licence open source — utilisation, modification et distribution libres, à condition de conserver les mentions de copyright et de signaler toute modification.
Au-delà de ce seuil, toute entité commerciale doit négocier un accord payant avec Liquid AI. Le modèle économique est explicitement assumé par la société : il s’agit d’« empêcher la propriété intellectuelle d’être absorbée gratuitement par les conglomérats technologiques, tout en semant le modèle au niveau des développeurs grassroots ». Pour un laboratoire académique français ou une jeune pousse européenne, c’est un cadre utilisable ; pour un déploiement dans une grande entreprise, il faut s’attendre à une renégociation.
L’intégration jour-1 dans llama.cpp, MLX, vLLM, SGLang et ONNX signalée par VentureBeat — confirmée par la recette officielle vLLM et par un post LinkedIn de l’équipe SGLang — abaisse la barrière à l’entrée pour les expérimentations internes.
Qui est Liquid AI, et d’où vient LFM2
L’entreprise a été fondée en décembre 2023 par quatre chercheurs issus du MIT Computer Science and Artificial Intelligence Laboratory (CSAIL) — Ramin Hasani, Mathias Lechner, Alexander Amini et Daniela Rus, rappelle Crypto Briefing. Son programme de recherche historique porte sur les « liquid neural networks », des architectures inspirées de systèmes neuronaux biologiques qui cherchent à optimiser le compromis qualité / latence / mémoire pour des contraintes matérielles spécifiques.
La trajectoire de financement est rapide : 37,5 millions de dollars de seed peu après la création, puis une Series A de 250 millions en décembre 2024 menée par AMD Ventures, pour un total d’environ 293 millions de dollars levés et une valorisation de l’ordre de 2 milliards, selon Crypto Briefing. La génération précédente LFM2, présentée par Liquid AI sur son blog officiel l’an passé, avait déjà affiché 2 fois plus rapide en decode et prefill que Qwen3 sur CPU, et 3 fois plus d’efficacité d’entraînement que la génération antérieure — ce qui fournit le socle industriel sur lequel s’appuie LFM2.5-230M.
Ce que ce lancement dit du mouvement « small models » en 2026
LFM2.5-230M n’arrive pas seul. VentureBeat relève que le milieu de l’année 2026 voit une effervescence autour des modèles compacts, avec des positionnements très différents selon les laboratoires :
- Weibo a publié VibeThinker-3B, un modèle de 3 milliards de paramètres bâti sur une base Qwen2 qui atteint 94,3 sur le benchmark de maths AIME 2026 — un score qui rivalise avec des modèles 200 fois plus gros, obtenu par curation agressive des données et apprentissage par renforcement ;
- Google a dépassé les 200 millions de téléchargements cumulés pour la famille Gemma 4, qui pousse explicitement la frontière vers l’embarqué, notamment avec la variante E2B (2 milliards de paramètres) pensée pour le mobile et l’IoT.
La leçon transversale, c’est que la course aux paramètres n’est plus le seul indicateur pertinent. Pour les tâches où la structuration compte plus que la fluidité linguistique — extraction, tool use, contrôle de robot, IoT — un petit modèle bien conçu peut offrir un meilleur rapport qualité/coût que ses grands frères, à condition d’accepter de renoncer à certaines tâches généralistes. LFM2.5-230M s’inscrit dans cette logique, avec une identité architecturale (le hybride LFM2) qui le distingue à la fois du transformer classique et des modèles de raisonnement renforcés.
Reste ouvert
Plusieurs éléments ne sont pas tranchés au moment où ces lignes sont écrites. Les benchmarks CaseReportBench et BFCLv3 sont publiés par Liquid AI et repris par VentureBeat et Crypto Briefing ; une vérification indépendante par un laboratoire tiers n’a pas, à ce stade, été rendue publique. Les chiffres de cadence sur Galaxy S25 Ultra et Raspberry Pi 5 sont également déclaratifs et dépendent des conditions de quantification et du runtime utilisé (llama.cpp, MLX, vLLM). Le coût réel d’inférence en production, une fois l’accord commercial négocié pour les entreprises au-dessus du seuil de 10 millions de dollars, n’est pas documenté publiquement. Enfin, les performances sur des langues autres que l’anglais, et en particulier sur le français, ne sont pas évoquées dans les sources consultées et méritent une évaluation dédiée avant tout déploiement.
Sources
- Liquid AI’s smallest model yet LFM2.5-230M beats models 4X its size at data extraction, can run ‘anywhere’ — VentureBeat, 25 juin 2026
- Liquid AI releases LFM2.5-230M model, outperforming larger competitors in data extraction — Crypto Briefing, 25 juin 2026
- Introducing LFM2: The Fastest On-Device Foundation Models on the Market — Liquid AI (blog officiel)
- LFM2.5-230M — page officielle de release — Liquid AI
- LiquidAI/LFM2.5-230M — recette d’inférence officielle — vLLM Recipes